---
title: Mise en cache des prompts
url: https://platform.claude.com/docs/fr/build-with-claude/prompt-caching
description: Mettez en cache les préfixes de prompts avec `cache_control` pour réduire les coûts et la latence, en utilisant la mise en cache automatique ou des points d'arrêt explicites avec des TTL de 5 minutes ou d'une heure.
---
Le « prompt caching » (mise en cache des prompts) optimise votre utilisation de l'API en permettant de reprendre le traitement à partir de préfixes spécifiques de vos prompts. Cela réduit considérablement le temps de traitement et les coûts pour les tâches répétitives ou les prompts comportant des éléments constants.
Pour savoir comment la « zero data retention » (rétention zéro des données), ou ZDR, s'applique à cette fonctionnalité, consultez [API et rétention des données](https://platform.claude.com/docs/fr/manage-claude/api-and-data-retention).
Il existe deux façons d'activer la mise en cache des prompts :
* **[Mise en cache automatique](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#automatic-caching)** : ajoutez un seul champ `cache_control` au niveau supérieur de votre requête. Le système applique automatiquement le « cache breakpoint » (point d'arrêt de cache) au dernier bloc pouvant être mis en cache et le fait avancer à mesure que les conversations s'allongent. Cette méthode est idéale pour les conversations multi-tours dont l'historique croissant des messages doit être mis en cache automatiquement.
* **[Points d'arrêt de cache explicites](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#explicit-cache-breakpoints)** : placez `cache_control` directement sur des blocs de contenu individuels pour contrôler précisément ce qui est mis en cache.
La façon la plus simple de commencer est d'utiliser la mise en cache automatique :
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"cache_control": {"type": "ephemeral"},
"system": "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
"messages": [
{
"role": "user",
"content": "Analyze the major themes in Pride and Prejudice."
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
cache_control:
type: ephemeral
system: >-
You are an AI assistant tasked with analyzing literary works. Your goal is
to provide insightful commentary on themes, characters, and writing style.
messages:
- role: user
content: Analyze the major themes in Pride and Prejudice.
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
cache_control={"type": "ephemeral"},
system="You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages=[
{
"role": "user",
"content": "Analyze the major themes in 'Pride and Prejudice'.",
}
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: { type: "ephemeral" },
system:
"You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages: [
{
role: "user",
content: "Analyze the major themes in 'Pride and Prejudice'."
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
CacheControl = new CacheControlEphemeral(),
System = "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
Messages =
[
new()
{
Role = Role.User,
Content = "Analyze the major themes in 'Pride and Prejudice'."
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
CacheControl: anthropic.NewCacheControlEphemeralParam(),
System: []anthropic.TextBlockParam{
{Text: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style."},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("Analyze the major themes in 'Pride and Prejudice'.")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class PromptCachingExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.cacheControl(CacheControlEphemeral.builder().build())
.system("You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.")
.addUserMessage("Analyze the major themes in 'Pride and Prejudice'.")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
use Anthropic\Messages\CacheControlEphemeral;
// ...
$client = new Client();
$response = $client->messages->create(
maxTokens: 1024,
messages: [
['role' => 'user', 'content' => "Analyze the major themes in 'Pride and Prejudice'."]
],
model: 'claude-opus-5-5',
cacheControl: CacheControlEphemeral::with(),
system: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
);
echo json_encode($response->usage);
```
```ruby Ruby
client = Anthropic::Client.new
response = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: {type: "ephemeral"},
system: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages: [
{
role: "user",
content: "Analyze the major themes in 'Pride and Prejudice'."
}
]
)
puts response.usage
```
Avec la mise en cache automatique, le système met en cache tout le contenu jusqu'au dernier bloc pouvant être mis en cache, inclus. Lors des requêtes suivantes ayant le même préfixe, le contenu mis en cache est réutilisé automatiquement.
***
## Fonctionnement de la mise en cache des prompts
Lorsque vous envoyez une requête avec la mise en cache des prompts activée :
1. Le système vérifie si un préfixe de prompt, jusqu'à un point d'arrêt de cache spécifié, est déjà en cache à la suite d'une requête récente.
2. S'il le trouve, il utilise la version mise en cache, ce qui réduit le temps de traitement et les coûts.
3. Sinon, il traite le prompt complet et met le préfixe en cache dès que la réponse commence.
Ceci est particulièrement utile pour :
* Les prompts comportant de nombreux exemples
* Les grandes quantités de contexte ou d'informations de fond
* Les tâches répétitives avec des instructions constantes
* Les longues conversations multi-tours
Par défaut, le cache a une durée de vie de 5 minutes. Le cache est actualisé sans coût supplémentaire chaque fois que le contenu mis en cache est utilisé.
La durée de vie est mesurée à partir du début de la requête qui écrit ou lit l'entrée de cache, et non à partir de la fin de sa réponse. Le temps passé à générer une réponse est décompté de la durée de vie : si le streaming d'une réponse prend 4 minutes, une requête de suivi qui réutilise le même préfixe mis en cache doit commencer dans un délai d'environ 1 minute après la fin de cette réponse.
Si vous trouvez que 5 minutes est une durée trop courte, Anthropic propose également une durée de cache d'une heure [moyennant un coût supplémentaire](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#pricing).
Pour plus d'informations, consultez [Durée de cache d'une heure](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#1-hour-cache-duration).
**La mise en cache des prompts met en cache le préfixe complet**
La mise en cache des prompts fait référence à l'intégralité du prompt : `tools`, `system` et `messages` (dans cet ordre), jusqu'au bloc désigné avec `cache_control`, inclus.
***
## Tarification
La mise en cache des prompts introduit une nouvelle structure tarifaire. Le tableau suivant indique le prix par million de tokens pour chaque modèle pris en charge :
| Model | Base input tokens | 5m cache writes | 1h cache writes | Cache hits and refreshes | Output tokens |
| :----------------------------------------------------------------------------------------------------------------------------------- | :---------------- | :-------------- | :-------------- | :----------------------- | :------------ |
| Claude Fable 5.1 | $10 / MTok | $12.50 / MTok | $20 / MTok | $0.25 / MTok1 | $50 / MTok |
| Claude Mythos 5.1 ([limited availability](https://support.claude.com/en/articles/14604842)) | $10 / MTok | $12.50 / MTok | $20 / MTok | $0.25 / MTok1 | $50 / MTok |
| Claude Fable 5 | $10 / MTok | $12.50 / MTok | $20 / MTok | $1 / MTok | $50 / MTok |
| Claude Mythos 5 ([limited availability](https://support.claude.com/en/articles/14604842)) | $10 / MTok | $12.50 / MTok | $20 / MTok | $1 / MTok | $50 / MTok |
| Claude Opus 5.5 | $4 / MTok | $5 / MTok | $8 / MTok | $0.20 / MTok2 | $20 / MTok |
| Claude Opus 5 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.8 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.7 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.6 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.5 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.1 ([retired, except on Bedrock and Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations)) | $15 / MTok | $18.75 / MTok | $30 / MTok | $1.50 / MTok | $75 / MTok |
| Claude Opus 4 ([retired, except on Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations)) | $15 / MTok | $18.75 / MTok | $30 / MTok | $1.50 / MTok | $75 / MTok |
| Claude Sonnet 5.5 | $2 / MTok | $2.50 / MTok | $4 / MTok | $0.10 / MTok2 | $10 / MTok |
| Claude Sonnet 5 | $2 / MTok | $2.50 / MTok | $4 / MTok | $0.20 / MTok | $10 / MTok |
| Claude Sonnet 4.6 | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Claude Sonnet 4.5 | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Claude Sonnet 4 ([retired, except on Bedrock and Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations)) | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Claude Haiku 5.5 (for prompts up to 100,000 tokens) | $0.10 / MTok | $0.125 / MTok | $0.20 / MTok | $0.01 / MTok | $0.50 / MTok |
| Claude Haiku 5.5 (for prompts over 100,000 tokens) | $0.50 / MTok | $0.625 / MTok | $1 / MTok | $0.05 / MTok | $2.50 / MTok |
| Claude Haiku 4.5 | $1 / MTok | $1.25 / MTok | $2 / MTok | $0.10 / MTok | $5 / MTok |
| Claude Haiku 3.5 ([retired, except on Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations)) | $0.80 / MTok | $1 / MTok | $1.60 / MTok | $0.08 / MTok | $4 / MTok |
*1 Cache hits and refreshes on Claude Fable 5.1 and Claude Mythos 5.1 are priced at 0.025x the base input price.*
*2 Cache hits and refreshes on Claude Opus 5.5 and Claude Sonnet 5.5 are priced at 0.05x the base input price.*
*All other models use the standard 0.1x multiplier.*
Le tableau précédent reflète les multiplicateurs de tarification suivants pour la mise en cache des prompts :
* Les tokens d'écriture en cache de 5 minutes coûtent 1,25 fois le prix de base des tokens d'entrée
* Les tokens d'écriture en cache d'une heure coûtent 2 fois le prix de base des tokens d'entrée
* Les tokens de lecture du cache coûtent 0,1 fois le prix de base des tokens d'entrée (consultez la note de bas de page du tableau pour les exceptions propres à certains modèles)
Ces multiplicateurs se cumulent avec d'autres modificateurs tarifaires tels que la remise de l'API Batch, la [tarification du contexte long](https://platform.claude.com/docs/fr/about-claude/pricing#long-context-pricing) et la résidence des données. Sur un modèle dont le prix dépend de la longueur du prompt, les lectures et écritures en cache comptent dans la longueur du prompt d'une requête. Consultez la [tarification](https://platform.claude.com/docs/fr/about-claude/pricing) pour tous les détails.
***
## Modèles pris en charge
La mise en cache des prompts (automatique comme explicite) est prise en charge sur tous les [modèles Claude actifs](https://platform.claude.com/docs/fr/models/overview).
***
## Mise en cache automatique
La mise en cache automatique est la façon la plus simple d'activer la mise en cache des prompts. Au lieu de placer `cache_control` sur des blocs de contenu individuels, ajoutez un seul champ `cache_control` au niveau supérieur du corps de votre requête. Le système applique automatiquement le point d'arrêt de cache au dernier bloc pouvant être mis en cache.
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"cache_control": {"type": "ephemeral"},
"system": "You are a helpful assistant that remembers our conversation.",
"messages": [
{"role": "user", "content": "My name is Alex. I work on machine learning."},
{"role": "assistant", "content": "Nice to meet you, Alex! How can I help with your ML work today?"},
{"role": "user", "content": "What did I say I work on?"}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
cache_control:
type: ephemeral
system: You are a helpful assistant that remembers our conversation.
messages:
- role: user
content: My name is Alex. I work on machine learning.
- role: assistant
content: Nice to meet you, Alex! How can I help with your ML work today?
- role: user
content: What did I say I work on?
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
cache_control={"type": "ephemeral"},
system="You are a helpful assistant that remembers our conversation.",
messages=[
{"role": "user", "content": "My name is Alex. I work on machine learning."},
{
"role": "assistant",
"content": "Nice to meet you, Alex! How can I help with your ML work today?",
},
{"role": "user", "content": "What did I say I work on?"},
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: { type: "ephemeral" },
system: "You are a helpful assistant that remembers our conversation.",
messages: [
{ role: "user", content: "My name is Alex. I work on machine learning." },
{
role: "assistant",
content: "Nice to meet you, Alex! How can I help with your ML work today?"
},
{ role: "user", content: "What did I say I work on?" }
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
CacheControl = new CacheControlEphemeral(),
System = "You are a helpful assistant that remembers our conversation.",
Messages =
[
new()
{
Role = Role.User,
Content = "My name is Alex. I work on machine learning."
},
new()
{
Role = Role.Assistant,
Content = "Nice to meet you, Alex! How can I help with your ML work today?"
},
new()
{
Role = Role.User,
Content = "What did I say I work on?"
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
CacheControl: anthropic.NewCacheControlEphemeralParam(),
System: []anthropic.TextBlockParam{
{Text: "You are a helpful assistant that remembers our conversation."},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("My name is Alex. I work on machine learning.")),
anthropic.NewAssistantMessage(anthropic.NewTextBlock("Nice to meet you, Alex! How can I help with your ML work today?")),
anthropic.NewUserMessage(anthropic.NewTextBlock("What did I say I work on?")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class AutomaticCachingExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.cacheControl(CacheControlEphemeral.builder().build())
.system("You are a helpful assistant that remembers our conversation.")
.addUserMessage("My name is Alex. I work on machine learning.")
.addAssistantMessage("Nice to meet you, Alex! How can I help with your ML work today?")
.addUserMessage("What did I say I work on?")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
use Anthropic\Messages\CacheControlEphemeral;
// ...
$client = new Client();
$response = $client->messages->create(
maxTokens: 1024,
messages: [
['role' => 'user', 'content' => 'My name is Alex. I work on machine learning.'],
['role' => 'assistant', 'content' => 'Nice to meet you, Alex! How can I help with your ML work today?'],
['role' => 'user', 'content' => 'What did I say I work on?'],
],
model: 'claude-opus-5-5',
cacheControl: CacheControlEphemeral::with(),
system: 'You are a helpful assistant that remembers our conversation.',
);
echo json_encode($response->usage);
```
```ruby Ruby
client = Anthropic::Client.new
response = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: {type: "ephemeral"},
system: "You are a helpful assistant that remembers our conversation.",
messages: [
{role: "user", content: "My name is Alex. I work on machine learning."},
{role: "assistant", content: "Nice to meet you, Alex! How can I help with your ML work today?"},
{role: "user", content: "What did I say I work on?"}
]
)
puts response.usage
```
### Fonctionnement de la mise en cache automatique dans les conversations multi-tours
Avec la mise en cache automatique, le point de cache avance automatiquement à mesure que les conversations s'allongent. Chaque nouvelle requête met en cache tout le contenu jusqu'au dernier bloc pouvant être mis en cache, et le contenu précédent est lu depuis le cache.
| Requête | Contenu | Comportement du cache |
| --------- | ----------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------- |
| Requête 1 | Système
+ Utilisateur(1) + Asst(1)
+ **Utilisateur(2)** ◀ cache | Tout est écrit dans le cache |
| Requête 2 | Système
+ Utilisateur(1) + Asst(1)
+ Utilisateur(2) + Asst(2)
+ **Utilisateur(3)** ◀ cache | Du Système jusqu'à Utilisateur(2) : lu depuis le cache ;
Asst(2) + Utilisateur(3) : écrits dans le cache |
| Requête 3 | Système
+ Utilisateur(1) + Asst(1)
+ Utilisateur(2) + Asst(2)
+ Utilisateur(3) + Asst(3)
+ **Utilisateur(4)** ◀ cache | Du Système jusqu'à Utilisateur(3) : lu depuis le cache ;
Asst(3) + Utilisateur(4) : écrits dans le cache |
Le point d'arrêt de cache se déplace automatiquement vers le dernier bloc pouvant être mis en cache dans chaque requête : vous n'avez donc pas besoin de mettre à jour les marqueurs `cache_control` à mesure que la conversation s'allonge.
### Prise en charge du TTL
Par défaut, la mise en cache automatique utilise un « time to live » (durée de vie), ou TTL, de 5 minutes. Vous pouvez spécifier un TTL d'une heure, facturé 2 fois le prix de base des tokens d'entrée :
```json
{ "cache_control": { "type": "ephemeral", "ttl": "1h" } }
```
### Combinaison avec la mise en cache au niveau des blocs
La mise en cache automatique est compatible avec les [points d'arrêt de cache explicites](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#explicit-cache-breakpoints). Lorsqu'ils sont utilisés ensemble, le point d'arrêt de cache automatique occupe l'un des 4 emplacements de points d'arrêt disponibles.
Cela vous permet de combiner les deux approches. Par exemple, utilisez un point d'arrêt explicite pour mettre en cache votre invite système, tandis que la mise en cache automatique gère la conversation :
```json
{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"cache_control": { "type": "ephemeral" },
"system": [
{
"type": "text",
"text": "You are a helpful assistant.",
"cache_control": { "type": "ephemeral" }
}
],
"messages": [{ "role": "user", "content": "What are the key terms?" }]
}
```
### Ce qui reste identique
La mise en cache automatique utilise la même infrastructure de mise en cache sous-jacente. La tarification, les seuils minimaux de tokens, les exigences d'ordre du contexte et la « lookback window » (fenêtre de rétrospection) de 20 blocs s'appliquent tous de la même manière qu'avec les points d'arrêt explicites.
### Cas particuliers
* Si le dernier bloc possède déjà un `cache_control` explicite avec le même TTL, la mise en cache automatique n'a aucun effet.
* Si le dernier bloc possède un `cache_control` explicite avec un TTL différent, l'API renvoie une erreur 400.
* Si 4 points d'arrêt explicites au niveau des blocs existent déjà, l'API renvoie une erreur 400 (il ne reste aucun emplacement pour la mise en cache automatique).
* Si le dernier bloc n'est pas éligible comme cible d'un point d'arrêt de cache automatique, le système remonte silencieusement pour trouver le bloc éligible le plus proche. S'il n'en trouve aucun, la mise en cache est ignorée.
La mise en cache automatique est disponible sur toutes les plateformes, à l'exception de l'intégration héritée [Amazon Bedrock (Opus 4.6 et versions antérieures)](https://platform.claude.com/docs/fr/build-with-claude/claude-on-amazon-bedrock-legacy). Sur cette intégration, l'API renvoie une erreur 400 pour un champ `cache_control` de niveau supérieur ; utilisez donc plutôt des [points d'arrêt de cache explicites](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#explicit-cache-breakpoints).
***
## Points d'arrêt de cache explicites
Pour mieux contrôler la mise en cache, vous pouvez placer `cache_control` directement sur des blocs de contenu individuels. Ceci est utile lorsque vous devez mettre en cache différentes sections qui changent à des fréquences différentes, ou lorsque vous avez besoin de contrôler précisément ce qui est mis en cache.
### Structurer votre prompt
Placez le contenu statique (définitions d'outils, instructions système, contexte, exemples) au début de votre prompt. Marquez la fin du contenu réutilisable à mettre en cache à l'aide du paramètre `cache_control`.
Les préfixes de cache sont créés dans l'ordre suivant : `tools`, `system`, puis `messages`. Cet ordre forme une hiérarchie dans laquelle chaque niveau s'appuie sur les précédents.
#### Fonctionnement de la vérification automatique des préfixes
Vous pouvez utiliser un seul point d'arrêt de cache à la fin de votre contenu statique, et le système trouvera automatiquement le plus long préfixe qu'une requête antérieure a déjà écrit dans le cache. Comprendre ce fonctionnement vous aide à optimiser votre stratégie de mise en cache.
**Trois principes fondamentaux :**
1. **Les « cache writes » (écritures en cache) ne se produisent qu'à votre point d'arrêt.** Marquer un bloc avec `cache_control` écrit exactement une entrée de cache : un hachage du préfixe se terminant à ce bloc. Le système n'écrit d'entrée pour aucune position antérieure. Comme le hachage est cumulatif et couvre tout le contenu jusqu'au point d'arrêt inclus, la modification de n'importe quel bloc situé au niveau du point d'arrêt ou avant celui-ci produit un hachage différent lors de la requête suivante.
2. **Les lectures du cache remontent en arrière à la recherche d'entrées écrites par des requêtes antérieures.** À chaque requête, le système calcule le hachage du préfixe à votre point d'arrêt et recherche une entrée de cache correspondante. S'il n'en existe aucune, il remonte un bloc à la fois, en vérifiant si le hachage du préfixe à chaque position antérieure correspond à une entrée déjà présente dans le cache. Il recherche des écritures antérieures, et non du contenu stable.
3. **La fenêtre de rétrospection est de 20 blocs.** Le système vérifie au maximum 20 positions par point d'arrêt, en comptant le point d'arrêt lui-même comme la première. Si le système ne trouve aucune entrée correspondante dans cette fenêtre, la vérification s'arrête (ou reprend à partir du point d'arrêt explicite suivant, s'il y en a un). Sur l'API Claude, une série de blocs `tool_use` consécutifs compte comme une seule position, tout comme une série de blocs `tool_result` consécutifs : un tour comportant de nombreux appels d'outils parallèles ne pousse donc pas à lui seul l'entrée de la requête précédente hors de la fenêtre.
**Exemple : rétrospection dans une conversation qui s'allonge**
Vous ajoutez de nouveaux blocs à chaque tour et définissez `cache_control` sur le dernier bloc de chaque requête :
* **Tour 1 :** 10 blocs, point d'arrêt sur le bloc 10. Aucune entrée de cache antérieure n'existe. Le système écrit une entrée au bloc 10.
* **Tour 2 :** 15 blocs, point d'arrêt sur le bloc 15. Le bloc 15 n'a pas d'entrée : le système remonte donc jusqu'au bloc 10 et trouve l'entrée du tour 1. « Cache hit » (succès de cache) au bloc 10 ; le système ne traite à nouveau que les blocs 11 à 15 et écrit une nouvelle entrée au bloc 15.
* **Tour 3 :** 35 blocs, point d'arrêt sur le bloc 35. Le système vérifie 20 positions (blocs 35 à 16) et ne trouve rien. L'entrée du tour 2 au bloc 15 se trouve une position en dehors de la fenêtre : il n'y a donc pas de succès de cache. L'ajout d'un second point d'arrêt au bloc 15 démarre une seconde fenêtre de rétrospection à cet endroit, qui trouve l'entrée du tour 2.
**Erreur courante : point d'arrêt sur un contenu qui change à chaque requête**
Votre prompt comporte un grand contexte système statique (blocs 1 à 5) suivi d'un bloc propre à chaque requête contenant un horodatage et le message de l'utilisateur (bloc 6). Vous définissez `cache_control` sur le bloc 6 :
* **Requête 1 :** écriture en cache au bloc 6. Le hachage inclut l'horodatage.
* **Requête 2 :** l'horodatage diffère, donc le hachage du préfixe au bloc 6 diffère. La rétrospection parcourt les blocs 5, 4, 3, 2 et 1, mais le système n'a jamais écrit d'entrée à aucune de ces positions. Aucun succès de cache. Vous payez une nouvelle écriture en cache à chaque requête et n'obtenez jamais de lecture.
La rétrospection ne trouve pas le contenu stable situé derrière votre point d'arrêt pour le mettre en cache. Elle trouve les entrées que des requêtes antérieures ont déjà écrites, et les écritures ne se produisent qu'aux points d'arrêt. Déplacez `cache_control` vers le bloc 5, le dernier bloc qui reste identique d'une requête à l'autre, et chaque requête suivante lira le préfixe mis en cache. La [mise en cache automatique](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#automatic-caching) tombe dans le même piège : elle place le point d'arrêt sur le dernier bloc pouvant être mis en cache, qui, dans cette structure, est celui qui change à chaque requête ; utilisez donc plutôt un point d'arrêt explicite sur le bloc 5.
**À retenir :** placez `cache_control` sur le dernier bloc dont le préfixe est identique dans toutes les requêtes qui doivent partager un cache. Dans une conversation qui s'allonge, le dernier bloc convient tant que chaque tour ajoute moins de 20 blocs : le contenu antérieur ne change jamais, de sorte que la rétrospection de la requête suivante trouve l'écriture précédente. Pour un prompt avec un suffixe variable (horodatages, contexte propre à chaque requête, message entrant), placez le point d'arrêt à la fin du préfixe statique, et non sur le bloc variable.
#### Quand utiliser plusieurs points d'arrêt
Vous pouvez définir jusqu'à 4 points d'arrêt de cache si vous souhaitez :
* Mettre en cache différentes sections qui changent à des fréquences différentes (par exemple, les outils changent rarement, mais le contexte est mis à jour quotidiennement)
* Contrôler plus précisément ce qui est mis en cache
* Garantir un succès de cache lorsqu'une conversation qui s'allonge pousse votre point d'arrêt 20 blocs ou plus au-delà de la dernière écriture en cache
**Limitation importante :** la rétrospection ne peut trouver que les entrées que des requêtes antérieures ont déjà écrites. Si une conversation qui s'allonge pousse votre point d'arrêt 20 blocs ou plus au-delà de la dernière écriture, la fenêtre de rétrospection ne la trouve pas. Ajoutez dès le départ un second point d'arrêt plus proche de cette position, afin qu'une écriture s'y accumule avant que vous en ayez besoin.
### Comprendre les coûts des points d'arrêt de cache
**Les points d'arrêt de cache eux-mêmes n'ajoutent aucun coût.** Vous n'êtes facturé que pour :
* **Les écritures en cache :** lorsque du nouveau contenu est écrit dans le cache (25 % de plus que les tokens d'entrée de base pour un TTL de 5 minutes)
* **Les lectures du cache :** lorsque du contenu en cache est utilisé (10 % du prix de base des tokens d'entrée, ou 2,5 % sur Claude Fable 5.1 et Claude Mythos 5.1, et 5 % sur Claude Opus 5.5 et Claude Sonnet 5.5)
* **Les tokens d'entrée ordinaires :** pour tout contenu non mis en cache
L'ajout de points d'arrêt `cache_control` supplémentaires n'augmente pas vos coûts ; vous payez toujours le même montant en fonction du contenu réellement mis en cache et lu. Les points d'arrêt vous permettent de contrôler quelles sections peuvent être mises en cache indépendamment.
***
## Stratégies et considérations de mise en cache
### Limitations du cache
Sur l'API Claude, [Claude Platform on AWS](https://platform.claude.com/docs/fr/build-with-claude/claude-platform-on-aws), [Google Cloud](https://platform.claude.com/docs/fr/build-with-claude/claude-on-vertex-ai) et [Microsoft Foundry](https://platform.claude.com/docs/fr/build-with-claude/claude-in-microsoft-foundry), la longueur minimale de prompt pouvant être mise en cache est de :
* 512 tokens pour Claude Fable 5.1, [Claude Mythos 5.1](https://platform.claude.com/docs/fr/models/mythos-5-1/overview), Claude Opus 5.5, Claude Opus 5, Claude Sonnet 5.5, Claude Fable 5, [Claude Mythos 5](https://platform.claude.com/docs/fr/models/mythos-5/overview) et Claude Haiku 5.5
* 2 048 tokens pour [Claude Mythos Preview](https://anthropic.com/glasswing) et Claude Opus 4.7
* 4 096 tokens pour Claude Opus 4.6 et Claude Opus 4.5
* 1 024 tokens pour Claude Opus 4.8, Claude Sonnet 5, Claude Sonnet 4.6, Claude Sonnet 4.5 ([déprécié](https://platform.claude.com/docs/fr/about-claude/model-deprecations)), Claude Opus 4.1 ([retiré, sauf sur Bedrock et Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations)), Claude Opus 4 ([retiré, sauf sur Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations)) et Claude Sonnet 4 ([retiré, sauf sur Bedrock et Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations))
* 4 096 tokens pour Claude Haiku 4.5
* 2 048 tokens pour Claude Haiku 3.5 ([retiré, sauf sur Google Cloud](https://platform.claude.com/docs/fr/about-claude/model-deprecations))
Ces minimums s'appliquent sur toutes les plateformes où chaque modèle est disponible.
Les prompts plus courts ne peuvent pas être mis en cache, même s'ils sont marqués avec `cache_control`. Toute requête visant à mettre en cache moins que ce nombre de tokens sera traitée sans mise en cache, et aucune erreur n'est renvoyée. Pour vérifier si un prompt a été mis en cache, consultez les [champs d'utilisation de la réponse](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#tracking-cache-performance) : si `cache_creation_input_tokens` et `cache_read_input_tokens` valent tous deux 0, le prompt n'a pas été mis en cache (probablement parce qu'il n'atteignait pas la longueur minimale requise).
Si votre prompt est juste en dessous du minimum pour votre modèle et votre plateforme, il est souvent intéressant d'étendre le contenu mis en cache pour atteindre le seuil. Les lectures du cache coûtent nettement moins cher que les tokens d'entrée non mis en cache, donc atteindre le minimum peut réduire les coûts pour les prompts fréquemment réutilisés.
[Bedrock](https://platform.claude.com/docs/fr/build-with-claude/claude-in-amazon-bedrock) est une plateforme exploitée par AWS. Sur Bedrock, consultez la [documentation de Bedrock sur la mise en cache des prompts](https://docs.aws.amazon.com/bedrock/latest/userguide/prompt-caching.html) pour connaître les minimums par modèle, le comportement en cas d'échec et les noms des champs d'utilisation applicables.
Pour les requêtes simultanées, notez qu'une entrée de cache ne devient disponible qu'après le début de la première réponse. Si vous avez besoin de succès de cache pour des requêtes parallèles, attendez la première réponse avant d'envoyer les requêtes suivantes.
Actuellement, « ephemeral » est le seul type de cache pris en charge, avec une durée de vie par défaut de 5 minutes.
### Ce qui peut être mis en cache
La plupart des blocs de la requête peuvent être mis en cache. Cela inclut :
* Les outils : définitions d'outils dans le tableau `tools`
* Les messages système : blocs de contenu dans le tableau `system`
* Les messages texte : blocs de contenu dans le tableau `messages.content`, pour les tours de l'utilisateur comme de l'assistant
* Les images et documents : blocs de contenu dans le tableau `messages.content`, dans les tours de l'utilisateur
* L'utilisation d'outils et les résultats d'outils : blocs de contenu dans le tableau `messages.content`, dans les tours de l'utilisateur comme de l'assistant
Chacun de ces éléments peut être mis en cache, soit automatiquement, soit en le marquant avec `cache_control`.
### Ce qui ne peut pas être mis en cache
Bien que la plupart des blocs de requête puissent être mis en cache, il existe quelques exceptions :
* Les blocs de réflexion ne peuvent pas être mis en cache directement avec `cache_control`. Cependant, les blocs de réflexion PEUVENT être mis en cache avec d'autres contenus lorsqu'ils apparaissent dans des tours précédents de l'assistant. Lorsqu'ils sont mis en cache de cette manière, ils SONT comptés comme des tokens d'entrée lorsqu'ils sont lus depuis le cache.
* Les blocs de sous-contenu (comme les [citations](https://platform.claude.com/docs/fr/build-with-claude/citations)) ne peuvent pas eux-mêmes être mis en cache directement. Mettez plutôt en cache le bloc de niveau supérieur.
Dans le cas des citations, les blocs de contenu de document de niveau supérieur qui servent de source aux citations peuvent être mis en cache. Cela vous permet d'utiliser efficacement la mise en cache des prompts avec les citations, en mettant en cache les documents auxquels les citations feront référence.
* Les blocs de texte vides ne peuvent pas être mis en cache.
### Ce qui invalide le cache
Les modifications du contenu mis en cache peuvent invalider tout ou partie du cache.
Comme décrit dans [Structurer votre prompt](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#structuring-your-prompt), le cache suit la hiérarchie : `tools` → `system` → `messages`. Les modifications à chaque niveau invalident ce niveau et tous les niveaux suivants.
Le tableau suivant indique quelles parties du cache sont invalidées par différents types de modifications. ✘ indique que le cache est invalidé, tandis que ✓ indique que le cache reste valide.
| Ce qui change | Cache des outils | Cache système | Cache des messages | Impact |
| ---------------------------------------------------------------------- | ---------------- | --------------- | ------------------ | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Définitions d'outils** | ✘ | ✘ | ✘ | La modification des définitions d'outils (noms, descriptions, paramètres) invalide l'intégralité du cache |
| **Activation de la recherche web** | ✓ | ✘ | ✘ | L'activation/désactivation de la recherche web modifie l'invite système |
| **Activation des citations** | ✓ | ✘ | ✘ | L'activation/désactivation des citations modifie l'invite système |
| **Paramètre de vitesse** | ✓ | ✘ | ✘ | Le passage entre [`speed: "fast"` et la vitesse standard](https://platform.claude.com/docs/fr/build-with-claude/fast-mode) invalide les caches système et des messages |
| **Choix d'outil** | ✓ | ✓ | ✘ | Les modifications du paramètre `tool_choice` n'affectent que les blocs de messages |
| **Images** | ✓ | ✓ | ✘ | L'ajout/la suppression d'images n'importe où dans le prompt affecte les blocs de messages |
| **Paramètres de réflexion** | Selon le modèle | Selon le modèle | ✘ | La configuration de réflexion (mode, et `budget_tokens` en mode étendu) est intégrée au prompt, donc la modifier invalide toujours les blocs de messages ; les caches des outils et du système sont également invalidés sur les modèles qui intègrent la configuration avant eux. Consultez [Réflexion et mise en cache des prompts](https://platform.claude.com/docs/fr/build-with-claude/thinking#thinking-and-prompt-caching). |
| **Paramètre d'effort** | Selon le modèle | Selon le modèle | ✘ | La modification de la valeur [`output_config.effort`](https://platform.claude.com/docs/fr/build-with-claude/effort) invalide toujours les blocs de messages, avec le même effet propre au modèle sur les caches des outils et du système que les paramètres de réflexion. Définir explicitement l'effort à la valeur par défaut du modèle équivaut à l'omettre et n'invalide pas le cache. Sur les modèles qui prennent en charge l'[effort par message](https://platform.claude.com/docs/fr/build-with-claude/effort#change-effort-mid-conversation-beta), un changement d'effort transmis dans un message `role: "system"` à l'intérieur de `messages` laisse le préfixe en cache intact. |
| **Résultats non liés aux outils transmis aux requêtes avec réflexion** | ✓ | ✓ | Selon le modèle | Sur Opus 4.5+, Sonnet 4.6+ et Haiku 5.5, les blocs de réflexion sont conservés par défaut, donc le cache reste valide (✓). Sur les modèles Opus/Sonnet antérieurs et les modèles Haiku jusqu'à Claude Haiku 4.5, tous les blocs de réflexion précédemment mis en cache sont retirés du contexte, et tous les messages qui suivent ces blocs de réflexion sont supprimés du cache (✘). Pour plus de détails, consultez [Mise en cache avec les blocs de réflexion](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#caching-with-thinking-blocks). |
| **Blocs de réflexion supprimés** | ✓ | ✓ | ✘ | Lorsque l'API supprime un bloc de réflexion de Claude Fable 5.1, Claude Mythos 5.1, Claude Opus 5.5, Claude Sonnet 5.5 ou Claude Haiku 5.5 qui n'est pas [préservé](https://platform.claude.com/docs/fr/build-with-claude/thinking#preserved-thinking) sur cette requête (par exemple, un bloc que vous renvoyez à un modèle qui ne peut pas le lire), le préfixe en cache change à partir de la position de ce bloc sur cette requête. Les blocs que le modèle destinataire peut lire, renvoyés sans modification, préservent le cache. |
Sur les modèles qui prennent en charge les [modifications d'outils en cours de conversation](https://platform.claude.com/docs/fr/build-with-claude/mid-conversation-system-messages#mid-conversation-tool-changes), l'en-tête bêta `inline-tools-2026-09-15` vous permet d'ajouter un outil, ou de modifier la définition d'un outil, en cours de conversation sans modifier `tools`. Envoyez la définition dans un bloc `tool_addition` au sein d'un message système en cours de conversation et laissez `tools` exactement tel que vous l'avez envoyé initialement. Le préfixe en cache correspond toujours, donc seul le message ajouté est traité comme une nouvelle entrée. La seule exception est un tableau `tools` sans aucun outil non différé, où le premier outil défini de cette manière coûte un « cache miss » (échec de cache) complet sur cette requête. Consultez [Définir des outils dans un message](https://platform.claude.com/docs/fr/build-with-claude/mid-conversation-system-messages#define-tools-in-a-message-beta).
Sur Claude Fable 5.1, [Claude Mythos 5.1](https://platform.claude.com/docs/fr/models/mythos-5-1/overview), Claude Fable 5, [Claude Mythos 5](https://platform.claude.com/docs/fr/models/mythos-5/overview), Claude Opus 5.5, Claude Opus 4.8, Claude Opus 5, Claude Sonnet 5.5 et Claude Haiku 5.5, vous pouvez ajouter une nouvelle instruction système en cours de conversation sans invalider les caches système ou des messages. Ajoutez un message `{"role": "system"}` à `messages` au lieu de modifier le champ `system` de niveau supérieur, afin que le préfixe en cache reste inchangé. Cette fonctionnalité n'est pas disponible sur Claude Sonnet 5. Utilisez plutôt le champ `system` de niveau supérieur. Consultez [Messages système en cours de conversation](https://platform.claude.com/docs/fr/build-with-claude/mid-conversation-system-messages).
### Suivi des performances du cache
Surveillez les performances du cache à l'aide des champs de réponse de l'API suivants, situés dans `usage` dans la réponse (ou dans l'événement `message_start` en cas de [streaming](https://platform.claude.com/docs/fr/build-with-claude/streaming)) :
* `cache_creation_input_tokens` : nombre de tokens écrits dans le cache lors de la création d'une nouvelle entrée.
* `cache_read_input_tokens` : nombre de tokens récupérés depuis le cache pour cette requête.
* `input_tokens` : nombre de tokens d'entrée qui n'ont été ni lus depuis le cache ni utilisés pour créer un cache (c'est-à-dire les tokens situés après le dernier point d'arrêt de cache).
**Comprendre la répartition des tokens**
Le champ `input_tokens` représente uniquement les tokens situés **après le dernier point d'arrêt de cache** dans votre requête, et non l'ensemble des tokens d'entrée que vous avez envoyés.
Pour calculer le total des tokens d'entrée :
```text wrap
total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens
```
**Explication spatiale :**
* `cache_read_input_tokens` = tokens situés avant le point d'arrêt et déjà mis en cache (lectures)
* `cache_creation_input_tokens` = tokens situés avant le point d'arrêt et en cours de mise en cache (écritures)
* `input_tokens` = tokens situés après votre dernier point d'arrêt (non éligibles au cache)
**Exemple :** si vous avez une requête comportant 100 000 tokens de contenu mis en cache (lus depuis le cache), 0 token de nouveau contenu en cours de mise en cache et 50 tokens dans votre message utilisateur (après le point d'arrêt de cache) :
* `cache_read_input_tokens` : 100 000
* `cache_creation_input_tokens` : 0
* `input_tokens` : 50
* **Total des tokens d'entrée traités :** 100 050 tokens
Ceci est important pour comprendre à la fois les coûts et les « rate limits » (limites de débit), car `input_tokens` sera généralement bien inférieur à votre entrée totale lorsque vous utilisez efficacement la mise en cache.
### Mise en cache avec les blocs de réflexion
Lorsque vous utilisez la [réflexion](https://platform.claude.com/docs/fr/build-with-claude/thinking) avec la mise en cache des prompts, les blocs de réflexion ont un comportement particulier :
**Mise en cache automatique avec d'autres contenus :** bien que les blocs de réflexion ne puissent pas être explicitement marqués avec `cache_control`, ils sont mis en cache dans le cadre du contenu de la requête lorsque vous effectuez des appels API ultérieurs avec des résultats d'outils. Cela se produit couramment lors de l'utilisation d'outils, lorsque vous renvoyez les blocs de réflexion pour poursuivre la conversation.
**Comptage des tokens d'entrée :** lorsque les blocs de réflexion sont lus depuis le cache, ils comptent comme des tokens d'entrée dans vos métriques d'utilisation. C'est important pour le calcul des coûts et la budgétisation des tokens.
**Schémas d'invalidation du cache :**
* Le cache reste valide lorsque seuls des résultats d'outils sont fournis comme messages utilisateur
* Sur Opus 4.5+, Sonnet 4.6+ et Haiku 5.5, les blocs de réflexion sont conservés par défaut même lorsque du contenu utilisateur autre que des résultats d'outils est ajouté, donc le cache reste valide
* Sur les modèles Opus/Sonnet antérieurs et les modèles Haiku jusqu'à Claude Haiku 4.5, le cache est invalidé lorsque du contenu utilisateur autre que des résultats d'outils est ajouté, ce qui entraîne le retrait de tous les blocs de réflexion précédents du contexte
* Ce comportement de mise en cache se produit même sans marqueurs `cache_control` explicites
Pour plus de détails sur l'invalidation du cache, consultez [Ce qui invalide le cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#what-invalidates-the-cache).
**Exemple avec utilisation d'outils :**
```text wrap
Request 1: User: "What's the weather in Paris?"
Response: [thinking_block_1] + [tool_use block 1]
Request 2:
User: ["What's the weather in Paris?"],
Assistant: [thinking_block_1] + [tool_use block 1],
User: [tool_result_1, cache=True]
Response: [thinking_block_2] + [text block 2]
# Request 2 caches its request content (not the response)
# The cache includes: user message, thinking_block_1, tool_use block 1, and tool_result_1
Request 3:
User: ["What's the weather in Paris?"],
Assistant: [thinking_block_1] + [tool_use block 1],
User: [tool_result_1, cache=True],
Assistant: [thinking_block_2] + [text block 2],
User: [Text response, cache=True]
# Depending on the model, this non-tool-result user block either keeps prior thinking blocks or strips them (see the next paragraph)
```
Sur les modèles Opus/Sonnet antérieurs et les modèles Haiku jusqu'à Claude Haiku 4.5, tous les blocs de réflexion précédents sont retirés du contexte à ce stade. Sur Opus 4.5+, Sonnet 4.6+ et Haiku 5.5, les blocs de réflexion antérieurs sont conservés par défaut et restent partie intégrante du préfixe en cache.
Pour des informations plus détaillées, consultez [Réflexion et mise en cache des prompts](https://platform.claude.com/docs/fr/build-with-claude/thinking#thinking-and-prompt-caching).
### Stockage et partage du cache
La mise en cache des prompts utilise une isolation au niveau de l'[espace de travail](https://platform.claude.com/docs/fr/manage-claude/workspaces). Les caches sont isolés par espace de travail, ce qui garantit la séparation des données entre les espaces de travail d'une même organisation. Cela s'applique à l'API Claude, à Claude Platform on AWS et à Microsoft Foundry ; Bedrock et Google Cloud maintiennent une isolation du cache au niveau de l'organisation. Si vous utilisez plusieurs espaces de travail, revoyez votre stratégie de mise en cache pour tenir compte de cette différence.
* **Isolation des organisations et des espaces de travail :** les caches sont isolés entre les organisations. Des organisations différentes ne partagent jamais de caches, même si elles utilisent des prompts identiques. Les caches sont également isolés par espace de travail au sein d'une organisation sur l'API Claude, Claude Platform on AWS et Microsoft Foundry ; Bedrock et Google Cloud utilisent uniquement une isolation au niveau de l'organisation.
* **Correspondance exacte :** les succès de cache nécessitent des segments de prompt identiques à 100 %, y compris l'ensemble du texte et des images jusqu'au bloc marqué avec le contrôle de cache, inclus.
* **Génération des tokens de sortie :** la mise en cache des prompts n'a aucun effet sur la génération des tokens de sortie. La réponse que vous recevez est identique à celle que vous obtiendriez sans mise en cache des prompts.
### Bonnes pratiques pour une mise en cache efficace
Pour optimiser les performances de la mise en cache des prompts :
* Commencez par la [mise en cache automatique](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#automatic-caching) pour les conversations multi-tours. Elle gère automatiquement les points d'arrêt.
* Utilisez des [points d'arrêt explicites au niveau des blocs](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#explicit-cache-breakpoints) lorsque vous devez mettre en cache différentes sections dont les fréquences de modification diffèrent.
* Mettez en cache le contenu stable et réutilisable, comme les instructions système, les informations de fond, les contextes volumineux ou les définitions d'outils fréquemment utilisées.
* Placez le contenu mis en cache au début du prompt pour obtenir les meilleures performances.
* Utilisez les points d'arrêt de cache de manière stratégique pour séparer les différentes sections de préfixe pouvant être mises en cache.
* Placez le point d'arrêt sur le dernier bloc qui reste identique d'une requête à l'autre. Pour un prompt avec un préfixe statique et un suffixe variable (horodatages, contexte propre à chaque requête, message entrant), il s'agit de la fin du préfixe, et non du bloc variable.
* Analysez régulièrement les taux de succès de cache et ajustez votre stratégie si nécessaire.
### Optimisation pour différents cas d'usage
Adaptez votre stratégie de mise en cache des prompts à votre scénario :
* Agents conversationnels : réduisez les coûts et la « latency » (latence) des conversations prolongées, en particulier celles comportant de longues instructions ou des documents téléversés.
* Assistants de codage : améliorez l'autocomplétion et les questions-réponses sur la base de code en conservant dans le prompt les sections pertinentes ou une version résumée de la base de code.
* Traitement de documents volumineux : intégrez dans votre prompt des contenus longs et complets, y compris des images, sans augmenter la latence de réponse.
* Ensembles d'instructions détaillées : partagez des listes étendues d'instructions, de procédures et d'exemples pour affiner les réponses de Claude. Les développeurs incluent souvent un ou deux exemples dans le prompt, mais avec la mise en cache des prompts, vous pouvez obtenir des performances encore meilleures en incluant plus de 20 exemples variés de réponses de haute qualité.
* Utilisation d'outils agentique : améliorez les performances des scénarios impliquant plusieurs appels d'outils et des modifications de code itératives, où chaque étape nécessite généralement un nouvel appel API.
* Dialoguer avec des livres, des articles, de la documentation, des transcriptions de podcasts et d'autres contenus longs : donnez vie à n'importe quelle base de connaissances en intégrant le ou les documents entiers dans le prompt et en permettant aux utilisateurs de lui poser des questions.
### Résolution des problèmes courants
En cas de comportement inattendu :
Les [diagnostics de cache](https://platform.claude.com/docs/fr/build-with-claude/cache-diagnostics) permettent à l'API de comparer des requêtes consécutives et d'indiquer où le préfixe du prompt a divergé, ce qui prend automatiquement en charge de nombreuses étapes de cette liste.
* Assurez-vous que les sections mises en cache sont identiques d'un appel à l'autre. Pour les points d'arrêt explicites, vérifiez que les marqueurs `cache_control` se trouvent aux mêmes emplacements
* Vérifiez que les appels sont effectués pendant la durée de vie du cache (5 minutes par défaut)
* Vérifiez que `tool_choice`, l'utilisation d'images, la configuration de réflexion et `output_config.effort` restent cohérents entre les appels
* Vérifiez que vous mettez en cache au moins le nombre minimal de tokens requis pour votre modèle et votre plateforme (consultez [Limitations du cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#cache-limitations))
* Confirmez que votre point d'arrêt se trouve sur un bloc qui reste identique d'une requête à l'autre. Les écritures en cache ne se produisent qu'au point d'arrêt, et si ce bloc change (horodatages, contexte propre à chaque requête, message entrant), le hachage du préfixe ne correspond jamais. La rétrospection ne trouve pas le contenu stable situé derrière le point d'arrêt ; elle ne trouve que les entrées que des requêtes antérieures ont écrites à leurs propres points d'arrêt
* Vérifiez que les clés de vos blocs de contenu `tool_use` ont un ordre stable, car certains langages (par exemple, Swift, Go) rendent aléatoire l'ordre des clés lors de la conversion JSON, ce qui casse les caches
* Utilisez les [diagnostics de cache](https://platform.claude.com/docs/fr/build-with-claude/cache-diagnostics) pour que l'API compare des requêtes consécutives et indique quelle partie du prompt a divergé
Les modifications de `tool_choice` ou la présence/l'absence d'images n'importe où dans le prompt invalideront le cache, ce qui nécessitera la création d'une nouvelle entrée de cache. Pour plus de détails sur l'invalidation du cache, consultez [Ce qui invalide le cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#what-invalidates-the-cache).
***
## Durée de cache d'une heure
Si vous trouvez que 5 minutes est une durée trop courte, Anthropic propose également une durée de cache d'une heure [moyennant un coût supplémentaire](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#pricing).
La durée de cache d'une heure est disponible sur l'API Claude, [Amazon Bedrock](https://platform.claude.com/docs/fr/build-with-claude/claude-in-amazon-bedrock), [Amazon Bedrock (Opus 4.6 et versions antérieures)](https://platform.claude.com/docs/fr/build-with-claude/claude-on-amazon-bedrock-legacy), [Claude Platform on AWS](https://platform.claude.com/docs/fr/build-with-claude/claude-platform-on-aws), [Google Cloud](https://platform.claude.com/docs/fr/build-with-claude/claude-on-vertex-ai) et [Microsoft Foundry](https://platform.claude.com/docs/fr/build-with-claude/claude-in-microsoft-foundry).
Pour utiliser le cache étendu, incluez `ttl` dans la définition `cache_control`, comme ceci :
```json
"cache_control": {
"type": "ephemeral",
"ttl": "1h"
}
```
La réponse inclut des informations détaillées sur le cache, comme suit :
```json Output
{
"usage": {
"input_tokens": 2048,
"cache_read_input_tokens": 1800,
"cache_creation_input_tokens": 248,
"output_tokens": 503,
"cache_creation": {
"ephemeral_5m_input_tokens": 148,
"ephemeral_1h_input_tokens": 100
}
}
}
```
Notez que le champ actuel `cache_creation_input_tokens` est égal à la somme des valeurs de l'objet `cache_creation`.
Si vous constatez des écritures `ephemeral_5m_input_tokens` que vous n'avez pas demandées lors de l'utilisation d'outils serveur tels que la recherche web, consultez [Utilisation d'outils avec la mise en cache des prompts](https://platform.claude.com/docs/fr/agents-and-tools/tool-use/tool-use-with-prompt-caching#server-tool-results-are-cached-automatically).
### Quand utiliser le cache d'une heure
Si vous avez des prompts utilisés à une cadence régulière (c'est-à-dire des invites système utilisées plus fréquemment que toutes les 5 minutes), continuez à utiliser le cache de 5 minutes, car celui-ci continuera d'être actualisé sans frais supplémentaires.
Le cache d'une heure est particulièrement adapté aux scénarios suivants :
* Lorsque vous avez des prompts susceptibles d'être utilisés moins fréquemment que toutes les 5 minutes, mais plus fréquemment que toutes les heures. Par exemple, lorsqu'un agent secondaire agentique prendra plus de 5 minutes, ou lorsque vous stockez une longue conversation avec un utilisateur et que vous vous attendez généralement à ce que cet utilisateur ne réponde pas dans les 5 prochaines minutes.
* Lorsque la latence est importante et que vos prompts de suivi peuvent être envoyés au-delà de 5 minutes.
* Lorsque vous souhaitez améliorer l'utilisation de votre limite de débit, car les succès de cache ne sont pas décomptés de votre limite de débit.
Le cache de 5 minutes et celui d'une heure se comportent de la même manière en ce qui concerne la latence. Vous constaterez généralement une amélioration du délai d'obtention du premier token pour les documents longs.
### Combiner différents TTL
Vous pouvez utiliser à la fois des contrôles de cache d'une heure et de 5 minutes dans la même requête, mais avec une contrainte importante : les entrées de cache ayant un TTL plus long doivent apparaître avant celles ayant un TTL plus court (c'est-à-dire qu'une entrée de cache d'une heure doit apparaître avant toute entrée de cache de 5 minutes).
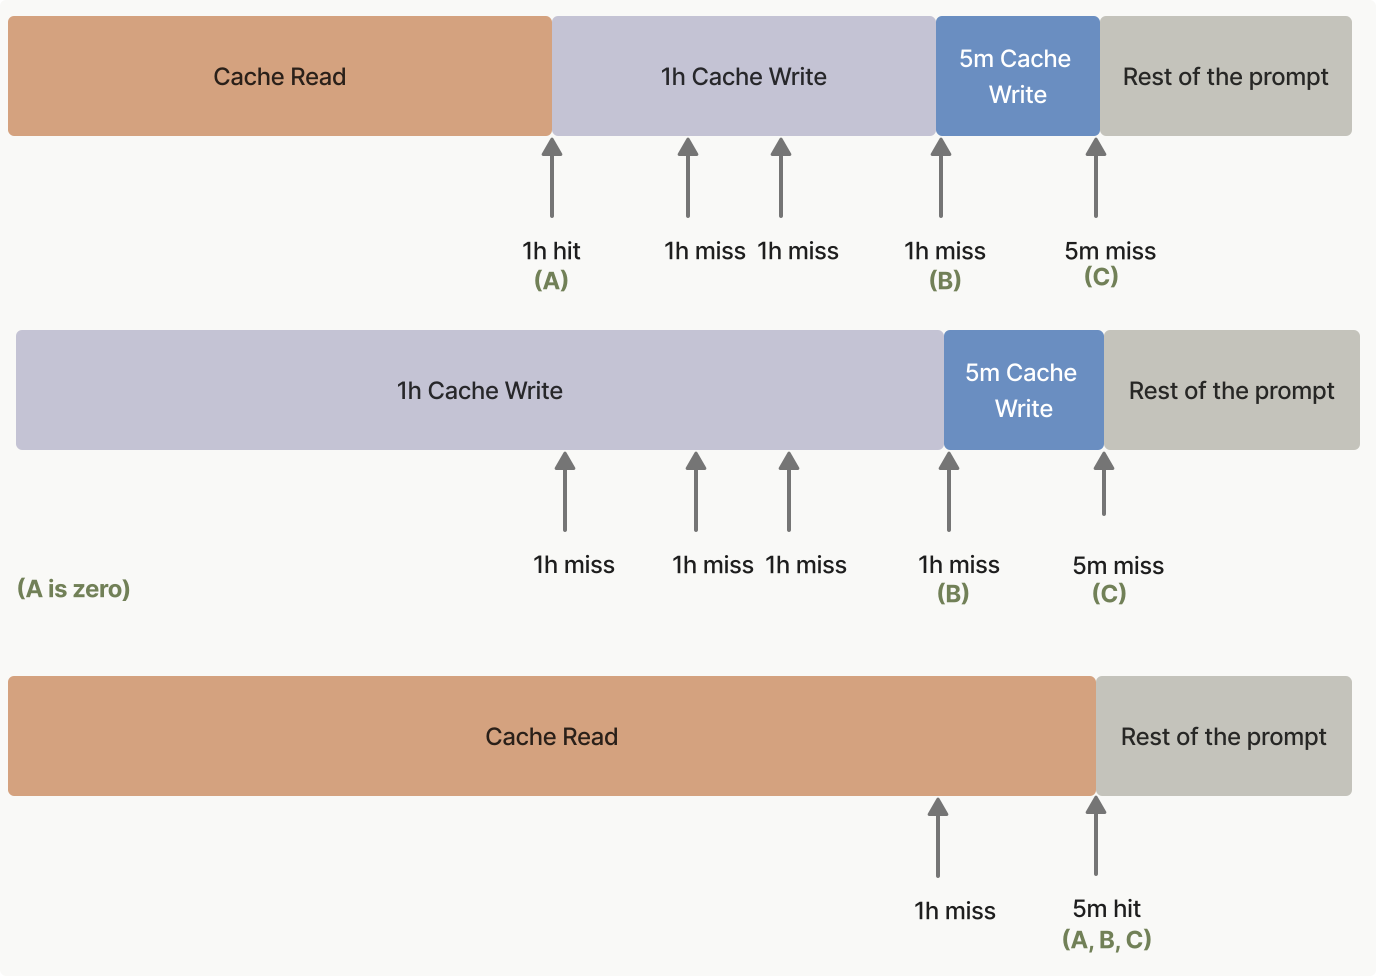
Lorsque vous combinez des TTL, l'API détermine trois emplacements de facturation dans votre prompt :
1. Position `A` : le nombre de tokens au niveau du succès de cache le plus élevé (ou 0 s'il n'y a aucun succès).
2. Position `B` : le nombre de tokens au niveau du bloc `cache_control` d'une heure le plus élevé après `A` (ou égal à `A` s'il n'en existe aucun).
3. Position `C` : le nombre de tokens au niveau du dernier bloc `cache_control`.
Si `B` ou `C` est supérieur à `A`, il s'agit nécessairement d'un échec de cache, car `A` est le succès de cache le plus élevé.
Vous serez facturé pour :
1. Les tokens de lecture du cache pour `A`.
2. Les tokens d'écriture du cache d'une heure pour `(B - A)`.
3. Les tokens d'écriture du cache de 5 minutes pour `(C - B)`.
Voici trois exemples. Ceci représente les tokens d'entrée de 3 requêtes, chacune ayant des succès et des échecs de cache différents. Chacune a donc une tarification calculée différente, indiquée dans les encadrés colorés.
***
## Préchauffage du cache
Le « cache pre-warming » (préchauffage du cache) vous permet de charger votre invite système ou vos définitions d'outils dans le cache des prompts avant qu'un utilisateur ne déclenche une requête réelle. Cela élimine la pénalité de latence liée à l'échec de cache lors de la première interaction utilisateur, réduisant le « time-to-first-token » (délai avant le premier token), ou TTFT, pour les applications sensibles à la latence.
### Fonctionnement
Définissez `max_tokens: 0` dans votre requête. L'API lit votre prompt dans le modèle et écrit le cache à chaque « breakpoint » (point d'arrêt) `cache_control`, puis renvoie immédiatement une réponse sans générer de sortie. La réponse contient un tableau `content` vide, `stop_reason: "max_tokens"` et un bloc `usage` entièrement renseigné.
Placez le point d'arrêt `cache_control` sur le dernier bloc partagé avec la requête suivante (généralement votre invite système ou vos définitions d'outils), et non sur le message utilisateur de substitution. Sinon, l'entrée de cache est associée au message de substitution et la requête suivante ne l'atteindra pas. Utilisez également la même configuration de réflexion et le même `output_config.effort` que vos requêtes suivantes : ces valeurs sont intégrées au prompt (voir [Ce qui invalide le cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#what-invalidates-the-cache)), de sorte qu'un préchauffage avec une configuration différente peut écrire une entrée que votre trafic réel n'atteindra jamais. Cela implique d'utiliser un [point d'arrêt de cache explicite](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#explicit-cache-breakpoints) plutôt que la [mise en cache automatique](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#automatic-caching), car la mise en cache automatique place le point d'arrêt sur le dernier bloc, qui est ici le message de substitution. Le message utilisateur de substitution peut être n'importe quelle chaîne contenant des caractères autres que des espaces (les exemples ici utilisent `"warmup"`) ; son contenu est lu par le modèle mais ne reçoit jamais de réponse.
Une requête de préchauffage entraîne des frais d'**écriture dans le cache** si le préfixe n'est pas déjà en cache, comme toute autre requête. Vérifiez `usage.cache_creation_input_tokens` dans la réponse pour confirmer qu'une écriture a eu lieu. Aucun token de sortie n'est facturé.
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 0,
"system": [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [{"role": "user", "content": "warmup"}]
}'
```
```bash CLI
ant messages create \
--transform '{stop_reason,content,usage}' --format yaml <<'YAML'
model: claude-opus-5-5
max_tokens: 0
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: warmup
YAML
```
```python Python
client = anthropic.Anthropic()
# Exécutez ceci avant l'arrivée des utilisateurs pour préchauffer le cache partagé de l'invite système.
prewarm = client.messages.create(
model="claude-opus-5-5",
max_tokens=0,
system=[
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"},
}
],
messages=[{"role": "user", "content": "warmup"}],
)
print(prewarm.stop_reason) # "max_tokens"
print(prewarm.content) # []
print(prewarm.usage)
```
```typescript TypeScript
const client = new Anthropic();
// Déclenchez ceci avant l'arrivée des utilisateurs pour préchauffer le cache partagé de l'invite système.
const prewarm = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 0,
system: [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: { type: "ephemeral" }
}
],
messages: [{ role: "user", content: "warmup" }]
});
console.log(prewarm.stop_reason); // "max_tokens"
console.log(prewarm.content); // []
console.log(prewarm.usage);
```
```csharp C#
AnthropicClient client = new();
var prewarm = await client.Messages.Create(
new()
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 0,
System = new(
[
new TextBlockParam
{
Text = "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl = new(),
},
]
),
Messages = [new() { Role = Role.User, Content = "warmup" }],
}
);
Console.WriteLine(prewarm.StopReason?.Raw()); // "max_tokens"
Console.WriteLine(prewarm.Content.Count); // 0
Console.WriteLine(prewarm.Usage);
```
```go Go
client := anthropic.NewClient()
prewarm, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 0,
System: []anthropic.TextBlockParam{
{
Text: "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("warmup")),
},
})
if err != nil {
panic(err)
}
fmt.Println(prewarm.StopReason) // "max_tokens"
fmt.Println(prewarm.Content) // []
fmt.Println(prewarm.Usage.RawJSON())
```
```java Java
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
Message prewarm = client.messages().create(MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(0)
.systemOfTextBlockParams(List.of(TextBlockParam.builder()
.text("You are an expert software engineer with deep knowledge of distributed systems...")
.cacheControl(CacheControlEphemeral.builder().build())
.build()))
.addUserMessage("warmup")
.build());
IO.println(prewarm.stopReason()); // Optional[max_tokens]
IO.println(prewarm.content()); // []
IO.println(prewarm.usage());
```
```php PHP
$client = new Client();
$prewarm = $client->messages->create(
model: Model::CLAUDE_OPUS_5_5,
maxTokens: 0,
system: [
[
'type' => 'text',
'text' => 'You are an expert software engineer with deep knowledge of distributed systems...',
'cache_control' => ['type' => 'ephemeral'],
],
],
messages: [['role' => 'user', 'content' => 'warmup']],
);
echo $prewarm->stopReason, PHP_EOL; // "max_tokens"
echo json_encode($prewarm->content), PHP_EOL; // []
echo json_encode($prewarm->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
prewarm = client.messages.create(
model: Anthropic::Model::CLAUDE_OPUS_5_5,
max_tokens: 0,
system_: [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: {type: "ephemeral"}
}
],
messages: [{role: "user", content: "warmup"}]
)
puts prewarm.stop_reason # :max_tokens
puts prewarm.content # []
puts prewarm.usage
```
L'API renvoie un tableau `content` vide :
```json Output
{
"id": "msg_01XFDUDYJgAACzvnptvVoYEL",
"type": "message",
"role": "assistant",
"content": [],
"model": "claude-opus-5-5",
"stop_reason": "max_tokens",
"stop_sequence": null,
"usage": {
"input_tokens": 8,
"cache_creation_input_tokens": 5120,
"cache_read_input_tokens": 0,
"cache_creation": {
"ephemeral_5m_input_tokens": 5120,
"ephemeral_1h_input_tokens": 0
},
"iterations": [
{
"input_tokens": 8,
"output_tokens": 0,
"cache_read_input_tokens": 0,
"cache_creation_input_tokens": 5120,
"cache_creation": {
"ephemeral_5m_input_tokens": 5120,
"ephemeral_1h_input_tokens": 0
},
"type": "message"
}
],
"output_tokens": 0,
"service_tier": "standard",
"inference_geo": "global"
}
}
```
### Modèle d'utilisation typique
Lancez une requête de préchauffage au démarrage de votre application (ou à intervalle planifié), puis envoyez les requêtes utilisateur réelles une fois le préchauffage terminé :
```bash cURL
# Préchauffez le cache au démarrage de l'application ou à intervalle planifié.
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 0,
"system": [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [{"role": "user", "content": "warmup"}]
}'
# Plus tard, lorsque l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"system": [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [{"role": "user", "content": "How do I implement a binary search tree?"}]
}'
```
```bash CLI
# Préchauffez le cache au démarrage de l'application ou à intervalle planifié.
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 0
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: warmup
YAML
# Plus tard, lorsque l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
ant messages create --transform 'content.#(type=="text").text' --raw-output <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: How do I implement a binary search tree?
YAML
```
```python Python
client = anthropic.Anthropic()
SYSTEM_PROMPT = [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"},
}
]
def prewarm_cache() -> None:
"""Call this at application startup or on a scheduled interval."""
client.messages.create(
model="claude-opus-5-5",
max_tokens=0,
system=SYSTEM_PROMPT,
messages=[{"role": "user", "content": "warmup"}],
)
def respond(user_message: str) -> anthropic.types.Message:
"""The real user request; benefits from a warm cache."""
return client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
system=SYSTEM_PROMPT,
messages=[{"role": "user", "content": user_message}],
)
# Préchauffez le cache avant l'arrivée de tout trafic utilisateur.
prewarm_cache()
# Plus tard, lorsque l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
response = respond("How do I implement a binary search tree?")
for block in response.content:
if block.type == "text":
print(block.text)
```
```typescript TypeScript
const client = new Anthropic();
const SYSTEM_PROMPT: Anthropic.TextBlockParam[] = [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: { type: "ephemeral" }
}
];
// Appelez ceci au démarrage de l'application ou à intervalle régulier.
async function prewarmCache(): Promise {
await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 0,
system: SYSTEM_PROMPT,
messages: [{ role: "user", content: "warmup" }]
});
}
// La vraie requête utilisateur ; elle profite d'un cache déjà chaud.
async function respond(userMessage: string): Promise {
return client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
system: SYSTEM_PROMPT,
messages: [{ role: "user", content: userMessage }]
});
}
// Préchauffez le cache avant l'arrivée de tout trafic utilisateur.
await prewarmCache();
// Plus tard, quand l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
const response = await respond("How do I implement a binary search tree?");
const textBlock = response.content.find(
(block): block is Anthropic.TextBlock => block.type === "text"
);
console.log(textBlock?.text);
```
```csharp C#
AnthropicClient client = new();
List systemPrompt =
[
new TextBlockParam
{
Text = "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl = new(),
},
];
// Appelez ceci au démarrage de l'application ou à intervalle régulier.
async Task PrewarmCache() =>
await client.Messages.Create(
new()
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 0,
System = new(systemPrompt),
Messages = [new() { Role = Role.User, Content = "warmup" }],
}
);
// La vraie requête utilisateur ; elle bénéficie d'un cache préchauffé.
async Task Respond(string userMessage) =>
await client.Messages.Create(
new()
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
System = new(systemPrompt),
Messages = [new() { Role = Role.User, Content = userMessage }],
}
);
// Préchauffez le cache avant l'arrivée de tout trafic utilisateur.
await PrewarmCache();
// Plus tard, lorsque l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
var response = await Respond("How do I implement a binary search tree?");
foreach (var block in response.Content)
{
if (block.TryPickText(out var textBlock))
{
Console.WriteLine(textBlock.Text);
}
}
```
```go Go
var client = anthropic.NewClient()
var systemPrompt = []anthropic.TextBlockParam{
{
Text: "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
}
// Appelez ceci au démarrage de l'application ou à intervalle régulier.
func prewarmCache() error {
_, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 0,
System: systemPrompt,
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("warmup")),
},
})
return err
}
// La vraie requête utilisateur ; elle profite d'un cache déjà chaud.
func respond(userMessage string) (*anthropic.Message, error) {
return client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
System: systemPrompt,
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock(userMessage)),
},
})
}
func main() {
// Préchauffez le cache avant l'arrivée de tout trafic utilisateur.
if err := prewarmCache(); err != nil {
log.Fatal(err)
}
// Plus tard, quand l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
response, err := respond("How do I implement a binary search tree?")
if err != nil {
log.Fatal(err)
}
for _, block := range response.Content {
if textBlock, ok := block.AsAny().(anthropic.TextBlock); ok {
fmt.Println(textBlock.Text)
}
}
}
```
```java Java
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
List systemPrompt = List.of(TextBlockParam.builder()
.text("You are an expert software engineer with deep knowledge of distributed systems...")
.cacheControl(CacheControlEphemeral.builder().build())
.build());
// Appelez ceci au démarrage de l'application ou à intervalle régulier.
void prewarmCache() {
client.messages().create(MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(0)
.systemOfTextBlockParams(systemPrompt)
.addUserMessage("warmup")
.build());
}
// La vraie requête utilisateur ; elle profite d'un cache déjà chaud.
Message respond(String userMessage) {
return client.messages().create(MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(systemPrompt)
.addUserMessage(userMessage)
.build());
}
void main() {
// Préchauffez le cache avant l'arrivée de tout trafic utilisateur.
prewarmCache();
// Plus tard, quand l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
Message response = respond("How do I implement a binary search tree?");
response.content().stream()
.flatMap(block -> block.text().stream())
.forEach(textBlock -> IO.println(textBlock.text()));
}
```
```php PHP
$client = new Client();
$systemPrompt = [
[
'type' => 'text',
'text' => 'You are an expert software engineer with deep knowledge of distributed systems...',
'cache_control' => ['type' => 'ephemeral'],
],
];
// Appelez ceci au démarrage de l'application ou à intervalle régulier.
$prewarmCache = fn () => $client->messages->create(
model: Model::CLAUDE_OPUS_5_5,
maxTokens: 0,
system: $systemPrompt,
messages: [['role' => 'user', 'content' => 'warmup']],
);
// La vraie requête utilisateur ; elle profite d'un cache déjà chaud.
$respond = fn (string $userMessage) => $client->messages->create(
model: Model::CLAUDE_OPUS_5_5,
maxTokens: 1024,
system: $systemPrompt,
messages: [['role' => 'user', 'content' => $userMessage]],
);
// Préchauffez le cache avant l'arrivée de tout trafic utilisateur.
$prewarmCache();
// Plus tard, quand l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
$response = $respond('How do I implement a binary search tree?');
foreach ($response->content as $block) {
if ($block->type === 'text') {
echo $block->text, PHP_EOL;
}
}
```
```ruby Ruby
client = Anthropic::Client.new
SYSTEM_PROMPT = [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: {type: "ephemeral"}
}
]
# Appelez ceci au démarrage de l'application ou à intervalle régulier.
def prewarm_cache(client)
client.messages.create(
model: Anthropic::Model::CLAUDE_OPUS_5_5,
max_tokens: 0,
system_: SYSTEM_PROMPT,
messages: [{role: "user", content: "warmup"}]
)
end
# La vraie requête utilisateur ; elle profite d'un cache déjà chaud.
def respond(client, user_message)
client.messages.create(
model: Anthropic::Model::CLAUDE_OPUS_5_5,
max_tokens: 1024,
system_: SYSTEM_PROMPT,
messages: [{role: "user", content: user_message}]
)
end
# Préchauffez le cache avant l'arrivée de tout trafic utilisateur.
prewarm_cache(client)
# Plus tard, quand l'utilisateur envoie un message, le préfixe de l'invite système est déjà en cache.
response = respond(client, "How do I implement a binary search tree?")
response.content.each do |block|
puts block.text if block.type == :text
end
```
Gardez à l'esprit que le TTL du cache s'applique toujours. Pour le cache par défaut de 5 minutes, envoyez une nouvelle requête de préchauffage au moins toutes les 5 minutes pour maintenir le cache chaud. Pour des intervalles plus longs entre les requêtes utilisateur, utilisez plutôt la [durée de cache d'une heure](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#1-hour-cache-duration).
### Limitations
Une requête `max_tokens: 0` est rejetée avec une `invalid_request_error` si l'un des éléments suivants est défini, car chacun implique une sortie qu'un budget de zéro token ne peut pas produire :
* `stream: true`
* [« Extended thinking » (réflexion étendue)](https://platform.claude.com/docs/fr/build-with-claude/extended-thinking) (`thinking.type: "enabled"`)
* [« Structured outputs » (sorties structurées)](https://platform.claude.com/docs/fr/build-with-claude/structured-outputs) (`output_config.format`)
* `tool_choice` de `{"type": "tool", ...}` ou `{"type": "any"}`
`max_tokens: 0` est également rejeté dans une requête [Message Batches](https://platform.claude.com/docs/fr/build-with-claude/batch-processing). Le préchauffage vise le délai avant le premier token, qui ne s'applique pas au traitement par lots, et une entrée de cache écrite pendant le traitement par lots expirerait probablement avant l'exécution de la requête suivante.
### Remplacer la solution de contournement max\_tokens=1
Avant que `max_tokens: 0` ne soit disponible, certaines applications utilisaient des appels de préchauffage avec `max_tokens: 1` pour obtenir le même effet. L'approche `max_tokens: 0` est préférable : aucune sortie n'est produite, il n'y a donc pas de réponse d'un seul token à ignorer, aucun token de sortie n'est facturé et l'intention de la requête est sans ambiguïté.
***
## Exemples de mise en cache des prompts
Pour vous aider à démarrer avec la « prompt caching » (mise en cache des prompts), le [cookbook sur la mise en cache des prompts](https://platform.claude.com/cookbook/misc-prompt-caching) fournit des exemples détaillés et des bonnes pratiques.
Les extraits de code suivants présentent divers modèles de mise en cache des prompts. Ces exemples montrent comment implémenter la mise en cache dans différents scénarios, afin de vous aider à comprendre les applications pratiques de cette fonctionnalité :
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-H "content-type: application/json" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"system": [
{
"type": "text",
"text": "You are an AI assistant tasked with analyzing legal documents."
},
{
"type": "text",
"text": "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [
{
"role": "user",
"content": "What are the key terms and conditions in this agreement?"
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
system:
- type: text
text: You are an AI assistant tasked with analyzing legal documents.
- type: text
text: >-
Here is the full text of a complex legal agreement:
[Insert full text of a 50-page legal agreement here]
cache_control:
type: ephemeral
messages:
- role: user
content: What are the key terms and conditions in this agreement?
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
system=[
{
"type": "text",
"text": "You are an AI assistant tasked with analyzing legal documents.",
},
{
"type": "text",
"text": "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
"cache_control": {"type": "ephemeral"},
},
],
messages=[
{
"role": "user",
"content": "What are the key terms and conditions in this agreement?",
}
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "You are an AI assistant tasked with analyzing legal documents."
},
{
type: "text",
text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "What are the key terms and conditions in this agreement?"
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new()
{
ApiKey = Environment.GetEnvironmentVariable("ANTHROPIC_API_KEY")
};
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
System = new MessageCreateParamsSystem(new List
{
new TextBlockParam()
{
Text = "You are an AI assistant tasked with analyzing legal documents.",
},
new TextBlockParam()
{
Text = "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new()
{
Role = Role.User,
Content = "What are the key terms and conditions in this agreement?"
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
System: []anthropic.TextBlockParam{
{
Text: "You are an AI assistant tasked with analyzing legal documents.",
},
{
Text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("What are the key terms and conditions in this agreement?")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class LegalDocumentAnalysisExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(
List.of(
TextBlockParam.builder()
.text("You are an AI assistant tasked with analyzing legal documents.")
.build(),
TextBlockParam.builder()
.text(
"Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
.addUserMessage("What are the key terms and conditions in this agreement?")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
$client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => 'What are the key terms and conditions in this agreement?'
]
],
model: 'claude-opus-5-5',
system: [
[
'type' => 'text',
'text' => 'You are an AI assistant tasked with analyzing legal documents.'
],
[
'type' => 'text',
'text' => 'Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]',
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
message = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "You are an AI assistant tasked with analyzing legal documents."
},
{
type: "text",
text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "What are the key terms and conditions in this agreement?"
}
]
)
puts message.usage
```
Cet exemple illustre l'utilisation de base de la mise en cache des prompts, en mettant en cache le texte intégral de l'accord juridique comme préfixe tout en laissant l'instruction utilisateur hors cache.
Pour la première requête :
* `input_tokens` : nombre de tokens dans le message utilisateur uniquement
* `cache_creation_input_tokens` : nombre de tokens dans l'ensemble du message système, y compris le document juridique
* `cache_read_input_tokens` : 0 (aucun succès de cache lors de la première requête)
Pour les requêtes suivantes pendant la durée de vie du cache :
* `input_tokens` : nombre de tokens dans le message utilisateur uniquement
* `cache_creation_input_tokens` : 0 (aucune nouvelle création de cache)
* `cache_read_input_tokens` : nombre de tokens dans l'ensemble du message système mis en cache
Les définitions d'outils peuvent être mises en cache en plaçant `cache_control` sur le dernier outil de votre tableau `tools`. Tous les outils définis jusqu'à cet outil inclus sont mis en cache comme un seul préfixe.
```json
{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"tools": [
{
"name": "get_weather",
"description": "Get the current weather in a given location",
"input_schema": {
"type": "object",
"properties": { "location": { "type": "string" } },
"required": ["location"]
}
},
{
"name": "get_time",
"description": "Get the current time in a given time zone",
"input_schema": {
"type": "object",
"properties": { "timezone": { "type": "string" } },
"required": ["timezone"]
},
"cache_control": { "type": "ephemeral" }
}
],
"messages": [{ "role": "user", "content": "What is the weather and time in New York?" }]
}
```
Lors de la première requête, `cache_creation_input_tokens` reflète le nombre de tokens de toutes les définitions d'outils. Lors des requêtes suivantes pendant la durée de vie du cache, ces tokens apparaissent plutôt sous `cache_read_input_tokens`.
Pour plus de détails sur l'interaction entre les définitions d'outils, `defer_loading` et l'invalidation du cache, consultez [Utilisation d'outils avec la mise en cache des prompts](https://platform.claude.com/docs/fr/agents-and-tools/tool-use/tool-use-with-prompt-caching).
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-H "content-type: application/json" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"system": [
{
"type": "text",
"text": "...long system prompt",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [
{
"role": "user",
"content": [
{
"type": "text",
"text": "Hello, can you tell me more about the solar system?"
}
]
},
{
"role": "assistant",
"content": "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
{
"role": "user",
"content": [
{
"type": "text",
"text": "Good to know."
},
{
"type": "text",
"text": "Tell me more about Mars.",
"cache_control": {"type": "ephemeral"}
}
]
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
system:
- type: text
text: "...long system prompt"
cache_control:
type: ephemeral
messages:
- role: user
content:
- type: text
text: Hello, can you tell me more about the solar system?
- role: assistant
content: >-
Certainly! The solar system is the collection of celestial bodies that
orbit our Sun. It consists of eight planets, numerous moons, asteroids,
comets, and other objects. The planets, in order from closest to farthest
from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus,
and Neptune. Each planet has its own unique characteristics and features.
Is there a specific aspect of the solar system you would like to know
more about?
- role: user
content:
- type: text
text: Good to know.
- type: text
text: Tell me more about Mars.
cache_control:
type: ephemeral
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
system=[
{
"type": "text",
"text": "...long system prompt",
"cache_control": {"type": "ephemeral"},
}
],
messages=[
# ...longue conversation jusqu'ici
{
"role": "user",
"content": [
{
"type": "text",
"text": "Hello, can you tell me more about the solar system?",
}
],
},
{
"role": "assistant",
"content": "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you'd like to know more about?",
},
{
"role": "user",
"content": [
{"type": "text", "text": "Good to know."},
{
"type": "text",
"text": "Tell me more about Mars.",
"cache_control": {"type": "ephemeral"},
},
],
},
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "...long system prompt",
cache_control: { type: "ephemeral" }
}
],
messages: [
// ...longue conversation jusqu'ici
{
role: "user",
content: [
{
type: "text",
text: "Hello, can you tell me more about the solar system?"
}
]
},
{
role: "assistant",
content:
"Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you'd like to know more about?"
},
{
role: "user",
content: [
{
type: "text",
text: "Good to know."
},
{
type: "text",
text: "Tell me more about Mars.",
cache_control: { type: "ephemeral" }
}
]
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
System = new MessageCreateParamsSystem(new List
{
new TextBlockParam()
{
Text = "...long system prompt",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new TextBlockParam("Hello, can you tell me more about the solar system?")),
}),
},
new()
{
Role = Role.Assistant,
Content = "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new TextBlockParam("Good to know.")),
new ContentBlockParam(new TextBlockParam()
{
Text = "Tell me more about Mars.",
CacheControl = new CacheControlEphemeral(),
}),
})
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
System: []anthropic.TextBlockParam{
{
Text: "...long system prompt",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("Hello, can you tell me more about the solar system?")),
anthropic.NewAssistantMessage(anthropic.NewTextBlock("Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?")),
{
Role: anthropic.MessageParamRoleUser,
Content: []anthropic.ContentBlockParamUnion{
anthropic.NewTextBlock("Good to know."),
{OfText: &anthropic.TextBlockParam{
Text: "Tell me more about Mars.",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
}},
},
},
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class ConversationWithCacheControlExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
// Créer une invite système éphémère
TextBlockParam systemPrompt = TextBlockParam.builder()
.text("...long system prompt")
.cacheControl(CacheControlEphemeral.builder().build())
.build();
// Créer les paramètres du message
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(List.of(systemPrompt))
// Premier message utilisateur (sans contrôle du cache)
.addUserMessage("Hello, can you tell me more about the solar system?")
// Réponse de l'assistant
.addAssistantMessage(
"Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
)
// Second message utilisateur (avec contrôle du cache)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(TextBlockParam.builder().text("Good to know.").build()),
ContentBlockParam.ofText(
TextBlockParam.builder()
.text("Tell me more about Mars.")
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
)
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
$client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => [
[
'type' => 'text',
'text' => 'Hello, can you tell me more about the solar system?'
]
]
],
[
'role' => 'assistant',
'content' => "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
],
[
'role' => 'user',
'content' => [
['type' => 'text', 'text' => 'Good to know.'],
[
'type' => 'text',
'text' => 'Tell me more about Mars.',
'cache_control' => ['type' => 'ephemeral']
]
]
]
],
model: 'claude-opus-5-5',
system: [
[
'type' => 'text',
'text' => '...long system prompt',
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
message = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "...long system prompt",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: [
{
type: "text",
text: "Hello, can you tell me more about the solar system?"
}
]
},
{
role: "assistant",
content: "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
{
role: "user",
content: [
{ type: "text", text: "Good to know." },
{
type: "text",
text: "Tell me more about Mars.",
cache_control: { type: "ephemeral" }
}
]
}
]
)
puts message.usage
```
Cet exemple montre comment utiliser la mise en cache des prompts dans une conversation multi-tours.
À chaque tour, le dernier bloc du dernier message est marqué avec `cache_control` afin que la conversation puisse être mise en cache de manière incrémentielle. Le système recherche et utilise automatiquement la plus longue séquence de blocs précédemment mise en cache pour les messages suivants. Autrement dit, les blocs qui étaient précédemment marqués avec un bloc `cache_control` ne le sont plus par la suite, mais ils seront toujours considérés comme un succès de cache (et aussi comme un rafraîchissement du cache !) s'ils sont atteints dans les 5 minutes.
De plus, notez que le paramètre `cache_control` est placé sur le message système. Cela garantit que, s'il est évincé du cache (après ne pas avoir été utilisé pendant plus de 5 minutes), il sera rajouté au cache lors de la requête suivante.
Cette approche est utile pour maintenir le contexte dans des conversations en cours sans traiter à plusieurs reprises les mêmes informations.
Lorsque cela est correctement configuré, vous devriez voir ce qui suit dans la réponse d'utilisation de chaque requête :
* `input_tokens` : nombre de tokens dans le nouveau message utilisateur (sera minimal)
* `cache_creation_input_tokens` : nombre de tokens dans les nouveaux tours de l'assistant et de l'utilisateur
* `cache_read_input_tokens` : nombre de tokens dans la conversation jusqu'au tour précédent
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-H "content-type: application/json" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"tools": [
{
"name": "search_documents",
"description": "Search through the knowledge base",
"input_schema": {
"type": "object",
"properties": {
"query": {
"type": "string",
"description": "Search query"
}
},
"required": ["query"]
}
},
{
"name": "get_document",
"description": "Retrieve a specific document by ID",
"input_schema": {
"type": "object",
"properties": {
"doc_id": {
"type": "string",
"description": "Document ID"
}
},
"required": ["doc_id"]
},
"cache_control": {"type": "ephemeral"}
}
],
"system": [
{
"type": "text",
"text": "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
"cache_control": {"type": "ephemeral"}
},
{
"type": "text",
"text": "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [
{
"role": "user",
"content": "Can you search for information about Mars rovers?"
},
{
"role": "assistant",
"content": [
{
"type": "tool_use",
"id": "tool_1",
"name": "search_documents",
"input": {"query": "Mars rovers"}
}
]
},
{
"role": "user",
"content": [
{
"type": "tool_result",
"tool_use_id": "tool_1",
"content": "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
"role": "assistant",
"content": [
{
"type": "text",
"text": "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
"role": "user",
"content": [
{
"type": "text",
"text": "Yes, please tell me about the Perseverance rover specifically.",
"cache_control": {"type": "ephemeral"}
}
]
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
tools:
- name: search_documents
description: Search through the knowledge base
input_schema:
type: object
properties:
query:
type: string
description: Search query
required: [query]
- name: get_document
description: Retrieve a specific document by ID
input_schema:
type: object
properties:
doc_id:
type: string
description: Document ID
required: [doc_id]
cache_control:
type: ephemeral
system:
- type: text
text: |-
You are a helpful research assistant with access to a document knowledge base.
# Instructions
- Always search for relevant documents before answering
- Provide citations for your sources
- Be objective and accurate in your responses
- If multiple documents contain relevant information, synthesize them
- Acknowledge when information is not available in the knowledge base
cache_control:
type: ephemeral
- type: text
text: |-
# Knowledge Base Context
Here are the relevant documents for this conversation:
## Document 1: Solar System Overview
The solar system consists of the Sun and all objects that orbit it...
## Document 2: Planetary Characteristics
Each planet has unique features. Mercury is the smallest planet...
## Document 3: Mars Exploration
Mars has been a target of exploration for decades...
[Additional documents...]
cache_control:
type: ephemeral
messages:
- role: user
content: Can you search for information about Mars rovers?
- role: assistant
content:
- type: tool_use
id: tool_1
name: search_documents
input:
query: Mars rovers
- role: user
content:
- type: tool_result
tool_use_id: tool_1
content: >-
Found 3 relevant documents: Document 3 (Mars Exploration),
Document 7 (Rover Technology), Document 9 (Mission History)
- role: assistant
content:
- type: text
text: >-
I found 3 relevant documents about Mars rovers. Let me get more
details from the Mars Exploration document.
- role: user
content:
- type: text
text: Yes, please tell me about the Perseverance rover specifically.
cache_control:
type: ephemeral
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
tools=[
{
"name": "search_documents",
"description": "Search through the knowledge base",
"input_schema": {
"type": "object",
"properties": {
"query": {"type": "string", "description": "Search query"}
},
"required": ["query"],
},
},
{
"name": "get_document",
"description": "Retrieve a specific document by ID",
"input_schema": {
"type": "object",
"properties": {
"doc_id": {"type": "string", "description": "Document ID"}
},
"required": ["doc_id"],
},
"cache_control": {"type": "ephemeral"},
},
],
system=[
{
"type": "text",
"text": "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
"cache_control": {"type": "ephemeral"},
},
{
"type": "text",
"text": "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
"cache_control": {"type": "ephemeral"},
},
],
messages=[
{
"role": "user",
"content": "Can you search for information about Mars rovers?",
},
{
"role": "assistant",
"content": [
{
"type": "tool_use",
"id": "tool_1",
"name": "search_documents",
"input": {"query": "Mars rovers"},
}
],
},
{
"role": "user",
"content": [
{
"type": "tool_result",
"tool_use_id": "tool_1",
"content": "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
}
],
},
{
"role": "assistant",
"content": [
{
"type": "text",
"text": "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.",
}
],
},
{
"role": "user",
"content": [
{
"type": "text",
"text": "Yes, please tell me about the Perseverance rover specifically.",
"cache_control": {"type": "ephemeral"},
}
],
},
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
tools: [
{
name: "search_documents",
description: "Search through the knowledge base",
input_schema: {
type: "object",
properties: {
query: {
type: "string",
description: "Search query"
}
},
required: ["query"]
}
},
{
name: "get_document",
description: "Retrieve a specific document by ID",
input_schema: {
type: "object",
properties: {
doc_id: {
type: "string",
description: "Document ID"
}
},
required: ["doc_id"]
},
cache_control: { type: "ephemeral" }
}
],
system: [
{
type: "text",
text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
cache_control: { type: "ephemeral" }
},
{
type: "text",
text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "Can you search for information about Mars rovers?"
},
{
role: "assistant",
content: [
{
type: "tool_use",
id: "tool_1",
name: "search_documents",
input: { query: "Mars rovers" }
}
]
},
{
role: "user",
content: [
{
type: "tool_result",
tool_use_id: "tool_1",
content:
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
role: "assistant",
content: [
{
type: "text",
text: "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
role: "user",
content: [
{
type: "text",
text: "Yes, please tell me about the Perseverance rover specifically.",
cache_control: { type: "ephemeral" }
}
]
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new()
{
ApiKey = Environment.GetEnvironmentVariable("ANTHROPIC_API_KEY")
};
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
Tools =
[
new ToolUnion(new Tool()
{
Name = "search_documents",
Description = "Search through the knowledge base",
InputSchema = new InputSchema()
{
Properties = new Dictionary
{
["query"] = JsonSerializer.SerializeToElement(new { type = "string", description = "Search query" }),
},
Required = ["query"],
},
}),
new ToolUnion(new Tool()
{
Name = "get_document",
Description = "Retrieve a specific document by ID",
InputSchema = new InputSchema()
{
Properties = new Dictionary
{
["doc_id"] = JsonSerializer.SerializeToElement(new { type = "string", description = "Document ID" }),
},
Required = ["doc_id"],
},
CacheControl = new CacheControlEphemeral(),
}),
],
System = new MessageCreateParamsSystem(new List
{
new TextBlockParam()
{
Text = "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
CacheControl = new CacheControlEphemeral(),
},
new TextBlockParam()
{
Text = "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new() { Role = Role.User, Content = "Can you search for information about Mars rovers?" },
new()
{
Role = Role.Assistant,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new ToolUseBlockParam()
{
ID = "tool_1",
Name = "search_documents",
Input = new Dictionary
{
["query"] = JsonSerializer.SerializeToElement("Mars rovers"),
},
}),
}),
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new ToolResultBlockParam()
{
ToolUseID = "tool_1",
Content = "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
}),
}),
},
new()
{
Role = Role.Assistant,
Content = "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.",
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new TextBlockParam()
{
Text = "Yes, please tell me about the Perseverance rover specifically.",
CacheControl = new CacheControlEphemeral(),
}),
}),
},
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
Tools: []anthropic.ToolUnionParam{
{OfTool: &anthropic.ToolParam{
Name: "search_documents",
Description: anthropic.String("Search through the knowledge base"),
InputSchema: anthropic.ToolInputSchemaParam{
Properties: map[string]any{
"query": map[string]any{
"type": "string",
"description": "Search query",
},
},
Required: []string{"query"},
},
}},
{OfTool: &anthropic.ToolParam{
Name: "get_document",
Description: anthropic.String("Retrieve a specific document by ID"),
InputSchema: anthropic.ToolInputSchemaParam{
Properties: map[string]any{
"doc_id": map[string]any{
"type": "string",
"description": "Document ID",
},
},
Required: []string{"doc_id"},
},
CacheControl: anthropic.NewCacheControlEphemeralParam(),
}},
},
System: []anthropic.TextBlockParam{
{
Text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
{
Text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("Can you search for information about Mars rovers?")),
anthropic.NewAssistantMessage(anthropic.NewToolUseBlock(
"tool_1",
map[string]any{"query": "Mars rovers"},
"search_documents",
)),
anthropic.NewUserMessage(anthropic.NewToolResultBlock(
"tool_1",
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
false,
)),
anthropic.NewAssistantMessage(anthropic.NewTextBlock("I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.")),
{
Role: anthropic.MessageParamRoleUser,
Content: []anthropic.ContentBlockParamUnion{
{OfText: &anthropic.TextBlockParam{
Text: "Yes, please tell me about the Perseverance rover specifically.",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
}},
},
},
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class MultipleCacheBreakpointsExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
// Schéma de l'outil de recherche
InputSchema searchSchema = InputSchema.builder()
.properties(
JsonValue.from(
Map.of("query", Map.of("type", "string", "description", "Search query"))
)
)
.putAdditionalProperty("required", JsonValue.from(List.of("query")))
.build();
// Schéma de l'outil de récupération de document
InputSchema getDocSchema = InputSchema.builder()
.properties(
JsonValue.from(
Map.of("doc_id", Map.of("type", "string", "description", "Document ID"))
)
)
.putAdditionalProperty("required", JsonValue.from(List.of("doc_id")))
.build();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
// Outils avec contrôle du cache sur le dernier
.addTool(
Tool.builder()
.name("search_documents")
.description("Search through the knowledge base")
.inputSchema(searchSchema)
.build()
)
.addTool(
Tool.builder()
.name("get_document")
.description("Retrieve a specific document by ID")
.inputSchema(getDocSchema)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
// Invites système avec contrôle du cache séparé pour les instructions et le contexte
.systemOfTextBlockParams(
List.of(
TextBlockParam.builder()
.text(
"You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build(),
TextBlockParam.builder()
.text(
"# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
// Historique de la conversation
.addUserMessage("Can you search for information about Mars rovers?")
.addAssistantMessageOfBlockParams(
List.of(
ContentBlockParam.ofToolUse(
ToolUseBlockParam.builder()
.id("tool_1")
.name("search_documents")
.input(JsonValue.from(Map.of("query", "Mars rovers")))
.build()
)
)
)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofToolResult(
ToolResultBlockParam.builder()
.toolUseId("tool_1")
.content(
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
)
.build()
)
)
)
.addAssistantMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(
TextBlockParam.builder()
.text(
"I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
)
.build()
)
)
)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(
TextBlockParam.builder()
.text("Yes, please tell me about the Perseverance rover specifically.")
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
)
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
$client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => 'Can you search for information about Mars rovers?'
],
[
'role' => 'assistant',
'content' => [
[
'type' => 'tool_use',
'id' => 'tool_1',
'name' => 'search_documents',
'input' => ['query' => 'Mars rovers']
]
]
],
[
'role' => 'user',
'content' => [
[
'type' => 'tool_result',
'tool_use_id' => 'tool_1',
'content' => 'Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)'
]
]
],
[
'role' => 'assistant',
'content' => [
[
'type' => 'text',
'text' => 'I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.'
]
]
],
[
'role' => 'user',
'content' => [
[
'type' => 'text',
'text' => 'Yes, please tell me about the Perseverance rover specifically.',
'cache_control' => ['type' => 'ephemeral']
]
]
]
],
model: 'claude-opus-5-5',
system: [
[
'type' => 'text',
'text' => "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
'cache_control' => ['type' => 'ephemeral']
],
[
'type' => 'text',
'text' => "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
'cache_control' => ['type' => 'ephemeral']
]
],
tools: [
[
'name' => 'search_documents',
'description' => 'Search through the knowledge base',
'input_schema' => [
'type' => 'object',
'properties' => [
'query' => [
'type' => 'string',
'description' => 'Search query'
]
],
'required' => ['query']
]
],
[
'name' => 'get_document',
'description' => 'Retrieve a specific document by ID',
'input_schema' => [
'type' => 'object',
'properties' => [
'doc_id' => [
'type' => 'string',
'description' => 'Document ID'
]
],
'required' => ['doc_id']
],
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
message = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
tools: [
{
name: "search_documents",
description: "Search through the knowledge base",
input_schema: {
type: "object",
properties: {
query: {
type: "string",
description: "Search query"
}
},
required: ["query"]
}
},
{
name: "get_document",
description: "Retrieve a specific document by ID",
input_schema: {
type: "object",
properties: {
doc_id: {
type: "string",
description: "Document ID"
}
},
required: ["doc_id"]
},
cache_control: { type: "ephemeral" }
}
],
system: [
{
type: "text",
text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
cache_control: { type: "ephemeral" }
},
{
type: "text",
text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "Can you search for information about Mars rovers?"
},
{
role: "assistant",
content: [
{
type: "tool_use",
id: "tool_1",
name: "search_documents",
input: { query: "Mars rovers" }
}
]
},
{
role: "user",
content: [
{
type: "tool_result",
tool_use_id: "tool_1",
content: "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
role: "assistant",
content: [
{
type: "text",
text: "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
role: "user",
content: [
{
type: "text",
text: "Yes, please tell me about the Perseverance rover specifically.",
cache_control: { type: "ephemeral" }
}
]
}
]
)
puts message.usage
```
Cet exemple complet montre comment utiliser les 4 points d'arrêt de cache disponibles pour optimiser différentes parties de votre prompt :
1. **Cache des outils** (point d'arrêt de cache 1) : le paramètre `cache_control` sur la dernière définition d'outil met en cache toutes les définitions d'outils.
2. **Cache des instructions réutilisables** (point d'arrêt de cache 2) : les instructions statiques de l'invite système sont mises en cache séparément. Ces instructions changent rarement d'une requête à l'autre.
3. **Cache du contexte RAG** (point d'arrêt de cache 3) : les documents de la base de connaissances sont mis en cache indépendamment, ce qui vous permet de mettre à jour les documents de « retrieval-augmented generation » (génération augmentée par récupération), ou RAG, sans invalider le cache des outils ou des instructions.
4. **Cache de l'historique de conversation** (point d'arrêt de cache 4) : le dernier message utilisateur est marqué avec `cache_control` pour permettre la mise en cache incrémentielle de la conversation au fur et à mesure de sa progression.
Cette approche offre une flexibilité maximale :
* Si vous ajoutez un nouveau tour à la conversation sans modifier le contenu antérieur, les quatre segments de cache sont réutilisés
* Si vous mettez à jour les documents RAG tout en conservant les mêmes outils et instructions, les deux premiers segments de cache sont réutilisés
* Si vous modifiez la conversation tout en conservant les mêmes outils, instructions et documents, les trois premiers segments sont réutilisés
* Les modifications à n'importe quel point d'arrêt invalident ce segment et tout ce qui le suit, tandis que les segments mis en cache antérieurs restent valides
Pour la première requête :
* `input_tokens` : minimal (tokens après le dernier point d'arrêt de cache, proche de 0 dans cet exemple)
* `cache_creation_input_tokens` : tokens de tous les segments mis en cache (outils + instructions + documents RAG + historique de conversation)
* `cache_read_input_tokens` : 0 (aucun succès de cache)
Pour les requêtes suivantes comportant uniquement un nouveau message utilisateur (et le quatrième point d'arrêt déplacé vers ce nouveau dernier message, comme dans l'exemple) :
* `input_tokens` : minimal (tokens après le dernier point d'arrêt de cache, proche de 0 dans cet exemple)
* `cache_creation_input_tokens` : tokens du nouveau message utilisateur et du tour précédent de l'assistant (le nouveau segment de conversation mis en cache)
* `cache_read_input_tokens` : tous les tokens précédemment mis en cache (outils + instructions + documents RAG + conversation précédente)
Ce modèle est particulièrement puissant pour :
* Les applications RAG avec de grands contextes documentaires
* Les systèmes d'agents qui utilisent plusieurs outils
* Les conversations de longue durée qui doivent maintenir le contexte
* Les applications qui doivent optimiser indépendamment différentes parties du prompt
## Conservation des données
La mise en cache des prompts (automatique et explicite) est éligible à la « Zero Data Retention » (conservation zéro des données), ou ZDR. Anthropic ne stocke pas le texte brut de vos prompts ni les réponses de Claude.
Les représentations du cache KV (clé-valeur) et les hachages cryptographiques du contenu mis en cache sont conservés uniquement en mémoire et ne sont pas stockés au repos. Les entrées mises en cache ont une durée de vie minimale de 5 minutes (standard) ou d'une heure (étendue), après quoi elles sont supprimées rapidement, mais pas immédiatement. Les entrées de cache sont isolées entre les organisations et, sur l'API Claude, Claude Platform on AWS et Microsoft Foundry, entre les espaces de travail au sein d'une organisation.
Pour l'éligibilité ZDR de l'ensemble des fonctionnalités, consultez [API et conservation des données](https://platform.claude.com/docs/fr/manage-claude/api-and-data-retention).
***
## FAQ
**Dans la plupart des cas, un seul point d'arrêt de cache à la fin de votre contenu statique suffit.** Les écritures dans le cache ont lieu uniquement au niveau du bloc que vous marquez. Placez-le sur le dernier bloc qui reste identique d'une requête à l'autre, et chaque requête suivante lira cette même entrée. Si un bloc ultérieur varie selon la requête (un horodatage, le message entrant), placez le point d'arrêt avant celui-ci, sur le dernier bloc stable.
Vous n'avez besoin de plusieurs points d'arrêt que si :
* Une conversation qui s'allonge repousse votre point d'arrêt de 20 blocs ou plus au-delà de la dernière écriture dans le cache, plaçant l'entrée précédente hors de la fenêtre de recherche rétrospective
* Vous souhaitez mettre en cache indépendamment des sections mises à jour à des fréquences différentes
* Vous avez besoin d'un contrôle explicite sur ce qui est mis en cache pour optimiser les coûts
Exemple : si vous avez des instructions système (qui changent rarement) et un contexte RAG (qui change quotidiennement), vous pouvez utiliser deux points d'arrêt pour les mettre en cache séparément.
Non, les points d'arrêt de cache eux-mêmes sont gratuits. Vous payez uniquement pour :
* L'écriture de contenu dans le cache (25 % de plus que les tokens d'entrée de base pour un TTL de 5 minutes)
* La lecture depuis le cache (une fraction du prix de base des tokens d'entrée, voir [Tarification](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#pricing))
* Les tokens d'entrée ordinaires pour le contenu non mis en cache
Le nombre de points d'arrêt n'affecte pas la tarification ; seule la quantité de contenu mis en cache et lu compte.
La réponse d'utilisation comprend trois champs distincts de tokens d'entrée qui, ensemble, représentent votre entrée totale :
```text wrap
total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens
```
* `cache_read_input_tokens` : tokens récupérés depuis le cache (tout ce qui précède les points d'arrêt de cache et qui a été mis en cache)
* `cache_creation_input_tokens` : nouveaux tokens écrits dans le cache (aux points d'arrêt de cache)
* `input_tokens` : tokens **après le dernier point d'arrêt de cache** qui ne sont pas mis en cache
**Important :** `input_tokens` ne représente PAS tous les tokens d'entrée, seulement la partie située après votre dernier point d'arrêt de cache. Si vous avez du contenu mis en cache, `input_tokens` sera généralement bien inférieur à votre entrée totale.
**Exemple :** avec un document de 200k tokens mis en cache et une question utilisateur de 50 tokens :
* `cache_read_input_tokens` : 200 000
* `cache_creation_input_tokens` : 0
* `input_tokens` : 50
* **Total :** 200 050 tokens
Cette répartition est essentielle pour comprendre à la fois vos coûts et votre utilisation des « rate limits » (limites de débit). Consultez [Suivi des performances du cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#tracking-cache-performance) pour plus de détails.
La durée de vie minimale par défaut du cache (TTL) est de 5 minutes. Cette durée de vie est rafraîchie chaque fois que le contenu mis en cache est utilisé.
Si vous trouvez que 5 minutes est trop court, Anthropic propose également un [TTL de cache d'une heure](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#1-hour-cache-duration).
La durée de vie est mesurée à partir du début de la requête qui écrit ou lit l'entrée de cache, et non à partir de la fin de sa réponse. Le temps passé à générer une réponse est décompté de la durée de vie, de sorte que la fenêtre pendant laquelle une requête suivante peut réutiliser le cache correspond à la durée de vie moins le temps de génération.
Si vos requêtes produisent de longues réponses et que la requête suivante risque de ne pas démarrer avant l'expiration de la durée de vie, utilisez le [TTL de cache d'une heure](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#1-hour-cache-duration).
Vous pouvez définir jusqu'à 4 points d'arrêt de cache (à l'aide des paramètres `cache_control`) dans votre prompt.
La mise en cache des prompts est prise en charge sur tous les [modèles Claude actifs](https://platform.claude.com/docs/fr/models/overview).
La modification des paramètres de réflexion (changement de mode, ou modification du budget en mode étendu) invalide les préfixes de messages mis en cache, et peut également invalider les invites système et les outils mis en cache, car la configuration de réflexion est intégrée au prompt. La valeur [`output_config.effort`](https://platform.claude.com/docs/fr/build-with-claude/effort) se comporte de la même manière.
Pour plus de détails sur l'invalidation du cache, consultez [Ce qui invalide le cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#what-invalidates-the-cache).
Pour en savoir plus sur la réflexion, y compris son interaction avec le « tool use » (utilisation d'outils) et la mise en cache des prompts, consultez [Réflexion et mise en cache des prompts](https://platform.claude.com/docs/fr/build-with-claude/thinking#thinking-and-prompt-caching).
Le moyen le plus simple consiste à ajouter `"cache_control": {"type": "ephemeral"}` au niveau supérieur du corps de votre requête ([mise en cache automatique](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#automatic-caching)). Vous pouvez également inclure au moins un point d'arrêt `cache_control` sur des blocs de contenu individuels ([points d'arrêt de cache explicites](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#explicit-cache-breakpoints)).
Oui, la mise en cache des prompts peut être utilisée avec d'autres fonctionnalités de l'API, comme l'utilisation d'outils et les capacités de vision. Cependant, modifier la présence d'images dans un prompt ou modifier les paramètres d'utilisation d'outils invalidera le cache.
Pour plus de détails sur l'invalidation du cache, consultez [Ce qui invalide le cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#what-invalidates-the-cache).
La mise en cache des prompts introduit une nouvelle structure tarifaire dans laquelle les écritures dans le cache de 5 minutes coûtent 25 % de plus que les tokens d'entrée de base, les écritures dans le cache d'une heure coûtent 2 fois le prix des tokens d'entrée de base, et les succès de cache coûtent une fraction du prix de base des tokens d'entrée (voir [Tarification](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#pricing) pour le multiplicateur par modèle).
Actuellement, il n'existe aucun moyen de vider le cache manuellement. Les préfixes mis en cache expirent automatiquement après un minimum de 5 minutes d'inactivité.
Vous pouvez surveiller les performances du cache à l'aide des champs `cache_creation_input_tokens` et `cache_read_input_tokens` dans la réponse de l'API.
Consultez [Ce qui invalide le cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#what-invalidates-the-cache) pour plus de détails sur l'invalidation du cache, y compris une liste des modifications qui nécessitent la création d'une nouvelle entrée de cache.
La mise en cache des prompts est conçue avec des mesures strictes de confidentialité et de séparation des données :
1. Les clés de cache sont générées à l'aide d'un hachage cryptographique des prompts jusqu'au point de contrôle du cache. Cela signifie que seules les requêtes ayant des prompts identiques peuvent accéder à un cache spécifique.
2. Sur l'API Claude, Claude Platform on AWS et Microsoft Foundry, les caches sont isolés par espace de travail au sein d'une organisation. Sur Bedrock et Google Cloud, les caches sont isolés par organisation. Dans tous les cas, les caches ne sont jamais partagés entre organisations, même pour des prompts identiques. Consultez [Stockage et partage du cache](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#cache-storage-and-sharing) pour plus de détails.
3. Le mécanisme de mise en cache est conçu pour préserver l'intégrité et la confidentialité de chaque conversation ou contexte unique.
4. Vous pouvez utiliser `cache_control` en toute sécurité n'importe où dans vos prompts. Pour que la mise en cache produise des lectures, placez le point d'arrêt à la fin d'un préfixe stable : le placer sur un bloc qui change à chaque requête (comme un horodatage ou une saisie arbitraire de l'utilisateur) écrit une nouvelle entrée à chaque fois et n'obtient jamais de succès de cache.
Ces mesures garantissent que la mise en cache des prompts préserve la confidentialité et la sécurité des données tout en offrant des avantages en termes de performances.
Oui, il est possible d'utiliser la mise en cache des prompts avec vos requêtes [API Batches](https://platform.claude.com/docs/fr/build-with-claude/batch-processing). Cependant, comme les requêtes par lots asynchrones peuvent être traitées simultanément et dans n'importe quel ordre, les succès de cache sont fournis dans la mesure du possible.
Le [cache d'une heure](https://platform.claude.com/docs/fr/build-with-claude/prompt-caching#1-hour-cache-duration) peut aider à améliorer vos succès de cache. La manière la plus rentable de l'utiliser est la suivante :
* Rassemblez un ensemble de requêtes de messages partageant un préfixe commun.
* Envoyez une requête par lots contenant une seule requête avec ce préfixe commun et un bloc de cache d'une heure. Cela écrit le préfixe dans le cache d'une heure.
* Dès que cela est terminé, soumettez le reste des requêtes. Vous devrez surveiller la tâche pour savoir quand elle se termine.
C'est généralement préférable à l'utilisation du cache de 5 minutes, car il est courant que les requêtes par lots prennent entre 5 minutes et 1 heure pour se terminer.
Cette erreur apparaît généralement lorsque vous avez mis à niveau votre SDK ou que vous utilisez des exemples de code obsolètes. La mise en cache des prompts ne nécessite plus le préfixe bêta. Au lieu de :
```python Python
client.beta.prompt_caching.messages.create(**params)
```
Utilisez :
```python Python
client.messages.create(**params)
```
Cette erreur apparaît généralement lorsque vous avez mis à niveau votre SDK ou que vous utilisez des exemples de code obsolètes. La mise en cache des prompts ne nécessite plus le préfixe bêta. Au lieu de :
```typescript TypeScript
client.beta.promptCaching.messages.create(/* ... */);
```
Utilisez :
```typescript
client.messages.create(/* ... */);
```