---
title: Cache de prompt
url: https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching
description: Armazene em cache prefixos de prompt com `cache_control` para reduzir custos e latência, usando cache automático ou pontos de interrupção explícitos com TTLs de 5 minutos ou 1 hora.
---
O "prompt caching" (cache de prompt) otimiza o uso da API ao permitir retomar o processamento a partir de prefixos específicos dos seus prompts. Isso reduz significativamente o tempo de processamento e os custos em tarefas repetitivas ou em prompts com elementos consistentes.
Para saber como a "zero data retention" (retenção zero de dados), ou ZDR, se aplica a este recurso, consulte [API e retenção de dados](https://platform.claude.com/docs/pt-BR/manage-claude/api-and-data-retention).
Há duas maneiras de habilitar o cache de prompt:
* **[Cache automático](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#automatic-caching)**: Adicione um único campo `cache_control` no nível superior da sua solicitação. O sistema aplica automaticamente o "cache breakpoint" (ponto de interrupção de cache) ao último bloco que pode ser armazenado em cache e o move para frente à medida que as conversas crescem. É a melhor opção para conversas de múltiplos turnos, em que o histórico crescente de mensagens deve ser armazenado em cache automaticamente.
* **[Pontos de interrupção de cache explícitos](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#explicit-cache-breakpoints)**: Coloque `cache_control` diretamente em blocos de conteúdo individuais para ter controle refinado sobre exatamente o que é armazenado em cache.
A maneira mais simples de começar é com o cache automático:
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"cache_control": {"type": "ephemeral"},
"system": "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
"messages": [
{
"role": "user",
"content": "Analyze the major themes in Pride and Prejudice."
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
cache_control:
type: ephemeral
system: >-
You are an AI assistant tasked with analyzing literary works. Your goal is
to provide insightful commentary on themes, characters, and writing style.
messages:
- role: user
content: Analyze the major themes in Pride and Prejudice.
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
cache_control={"type": "ephemeral"},
system="You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages=[
{
"role": "user",
"content": "Analyze the major themes in 'Pride and Prejudice'.",
}
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: { type: "ephemeral" },
system:
"You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages: [
{
role: "user",
content: "Analyze the major themes in 'Pride and Prejudice'."
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
CacheControl = new CacheControlEphemeral(),
System = "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
Messages =
[
new()
{
Role = Role.User,
Content = "Analyze the major themes in 'Pride and Prejudice'."
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
CacheControl: anthropic.NewCacheControlEphemeralParam(),
System: []anthropic.TextBlockParam{
{Text: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style."},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("Analyze the major themes in 'Pride and Prejudice'.")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class PromptCachingExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.cacheControl(CacheControlEphemeral.builder().build())
.system("You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.")
.addUserMessage("Analyze the major themes in 'Pride and Prejudice'.")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
use Anthropic\Messages\CacheControlEphemeral;
// ...
$client = new Client();
$response = $client->messages->create(
maxTokens: 1024,
messages: [
['role' => 'user', 'content' => "Analyze the major themes in 'Pride and Prejudice'."]
],
model: 'claude-opus-5-5',
cacheControl: CacheControlEphemeral::with(),
system: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
);
echo json_encode($response->usage);
```
```ruby Ruby
client = Anthropic::Client.new
response = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: {type: "ephemeral"},
system: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages: [
{
role: "user",
content: "Analyze the major themes in 'Pride and Prejudice'."
}
]
)
puts response.usage
```
Com o cache automático, o sistema armazena em cache todo o conteúdo até o último bloco que pode ser armazenado em cache, inclusive. Em solicitações subsequentes com o mesmo prefixo, o conteúdo em cache é reutilizado automaticamente.
***
## Como o cache de prompt funciona
Quando você envia uma solicitação com o cache de prompt habilitado:
1. O sistema verifica se um prefixo do prompt, até um ponto de interrupção de cache especificado, já está em cache a partir de uma consulta recente.
2. Se encontrado, ele usa a versão em cache, reduzindo o tempo de processamento e os custos.
3. Caso contrário, ele processa o prompt completo e armazena o prefixo em cache assim que a resposta começa.
Isso é especialmente útil para:
* Prompts com muitos exemplos
* Grandes quantidades de contexto ou informações de base
* Tarefas repetitivas com instruções consistentes
* Conversas longas de múltiplos turnos
Por padrão, o cache tem um tempo de vida de 5 minutos. O cache é renovado sem custo adicional sempre que o conteúdo em cache é usado.
O tempo de vida é medido a partir do início da solicitação que grava ou lê a entrada de cache, e não a partir do fim da sua resposta. O tempo gasto gerando uma resposta conta contra o tempo de vida: se uma resposta leva 4 minutos para ser transmitida via streaming, uma solicitação de acompanhamento que reutiliza o mesmo prefixo em cache deve começar em cerca de 1 minuto após a conclusão dessa resposta.
Se você achar que 5 minutos é pouco tempo, a Anthropic também oferece uma duração de cache de 1 hora [com custo adicional](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#pricing).
Para mais informações, consulte [Duração de cache de 1 hora](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#1-hour-cache-duration).
**O cache de prompt armazena o prefixo completo**
O cache de prompt referencia o prompt inteiro: `tools`, `system` e `messages` (nessa ordem), até o bloco designado com `cache_control`, inclusive.
***
## Preços
O cache de prompt introduz uma nova estrutura de preços. A tabela a seguir mostra o preço por milhão de tokens para cada modelo compatível:
| Model | Base input tokens | 5m cache writes | 1h cache writes | Cache hits and refreshes | Output tokens |
| :-------------------------------------------------------------------------------------------------------------------------------------- | :---------------- | :-------------- | :-------------- | :----------------------- | :------------ |
| Claude Fable 5.1 | $10 / MTok | $12.50 / MTok | $20 / MTok | $0.25 / MTok1 | $50 / MTok |
| Claude Mythos 5.1 ([limited availability](https://support.claude.com/en/articles/14604842)) | $10 / MTok | $12.50 / MTok | $20 / MTok | $0.25 / MTok1 | $50 / MTok |
| Claude Fable 5 | $10 / MTok | $12.50 / MTok | $20 / MTok | $1 / MTok | $50 / MTok |
| Claude Mythos 5 ([limited availability](https://support.claude.com/en/articles/14604842)) | $10 / MTok | $12.50 / MTok | $20 / MTok | $1 / MTok | $50 / MTok |
| Claude Opus 5.5 | $4 / MTok | $5 / MTok | $8 / MTok | $0.20 / MTok2 | $20 / MTok |
| Claude Opus 5 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.8 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.7 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.6 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.5 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Claude Opus 4.1 ([retired, except on Bedrock and Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations)) | $15 / MTok | $18.75 / MTok | $30 / MTok | $1.50 / MTok | $75 / MTok |
| Claude Opus 4 ([retired, except on Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations)) | $15 / MTok | $18.75 / MTok | $30 / MTok | $1.50 / MTok | $75 / MTok |
| Claude Sonnet 5.5 | $2 / MTok | $2.50 / MTok | $4 / MTok | $0.10 / MTok2 | $10 / MTok |
| Claude Sonnet 5 | $2 / MTok | $2.50 / MTok | $4 / MTok | $0.20 / MTok | $10 / MTok |
| Claude Sonnet 4.6 | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Claude Sonnet 4.5 | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Claude Sonnet 4 ([retired, except on Bedrock and Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations)) | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Claude Haiku 5.5 (for prompts up to 100,000 tokens) | $0.10 / MTok | $0.125 / MTok | $0.20 / MTok | $0.01 / MTok | $0.50 / MTok |
| Claude Haiku 5.5 (for prompts over 100,000 tokens) | $0.50 / MTok | $0.625 / MTok | $1 / MTok | $0.05 / MTok | $2.50 / MTok |
| Claude Haiku 4.5 | $1 / MTok | $1.25 / MTok | $2 / MTok | $0.10 / MTok | $5 / MTok |
| Claude Haiku 3.5 ([retired, except on Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations)) | $0.80 / MTok | $1 / MTok | $1.60 / MTok | $0.08 / MTok | $4 / MTok |
*1 Cache hits and refreshes on Claude Fable 5.1 and Claude Mythos 5.1 are priced at 0.025x the base input price.*
*2 Cache hits and refreshes on Claude Opus 5.5 and Claude Sonnet 5.5 are priced at 0.05x the base input price.*
*All other models use the standard 0.1x multiplier.*
A tabela anterior reflete os seguintes multiplicadores de preço para o cache de prompt:
* Tokens de gravação em cache de 5 minutos custam 1,25 vez o preço base dos tokens de entrada
* Tokens de gravação em cache de 1 hora custam 2 vezes o preço base dos tokens de entrada
* Tokens de leitura de cache custam 0,1 vez o preço base dos tokens de entrada (consulte a nota de rodapé da tabela para exceções por modelo)
Esses multiplicadores se acumulam com outros modificadores de preço, como o desconto da Batch API, [preços de contexto longo](https://platform.claude.com/docs/pt-BR/about-claude/pricing#long-context-pricing) e residência de dados. Em um modelo com preço baseado no comprimento do prompt, leituras e gravações de cache contam para o comprimento do prompt de uma solicitação. Consulte [preços](https://platform.claude.com/docs/pt-BR/about-claude/pricing) para detalhes completos.
***
## Modelos compatíveis
O cache de prompt (tanto automático quanto explícito) é compatível com todos os [modelos Claude ativos](https://platform.claude.com/docs/pt-BR/models/overview).
***
## Cache automático
O cache automático é a maneira mais simples de habilitar o cache de prompt. Em vez de colocar `cache_control` em blocos de conteúdo individuais, adicione um único campo `cache_control` no nível superior do corpo da sua solicitação. O sistema aplica automaticamente o ponto de interrupção de cache ao último bloco que pode ser armazenado em cache.
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"cache_control": {"type": "ephemeral"},
"system": "You are a helpful assistant that remembers our conversation.",
"messages": [
{"role": "user", "content": "My name is Alex. I work on machine learning."},
{"role": "assistant", "content": "Nice to meet you, Alex! How can I help with your ML work today?"},
{"role": "user", "content": "What did I say I work on?"}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
cache_control:
type: ephemeral
system: You are a helpful assistant that remembers our conversation.
messages:
- role: user
content: My name is Alex. I work on machine learning.
- role: assistant
content: Nice to meet you, Alex! How can I help with your ML work today?
- role: user
content: What did I say I work on?
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
cache_control={"type": "ephemeral"},
system="You are a helpful assistant that remembers our conversation.",
messages=[
{"role": "user", "content": "My name is Alex. I work on machine learning."},
{
"role": "assistant",
"content": "Nice to meet you, Alex! How can I help with your ML work today?",
},
{"role": "user", "content": "What did I say I work on?"},
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: { type: "ephemeral" },
system: "You are a helpful assistant that remembers our conversation.",
messages: [
{ role: "user", content: "My name is Alex. I work on machine learning." },
{
role: "assistant",
content: "Nice to meet you, Alex! How can I help with your ML work today?"
},
{ role: "user", content: "What did I say I work on?" }
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
CacheControl = new CacheControlEphemeral(),
System = "You are a helpful assistant that remembers our conversation.",
Messages =
[
new()
{
Role = Role.User,
Content = "My name is Alex. I work on machine learning."
},
new()
{
Role = Role.Assistant,
Content = "Nice to meet you, Alex! How can I help with your ML work today?"
},
new()
{
Role = Role.User,
Content = "What did I say I work on?"
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
CacheControl: anthropic.NewCacheControlEphemeralParam(),
System: []anthropic.TextBlockParam{
{Text: "You are a helpful assistant that remembers our conversation."},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("My name is Alex. I work on machine learning.")),
anthropic.NewAssistantMessage(anthropic.NewTextBlock("Nice to meet you, Alex! How can I help with your ML work today?")),
anthropic.NewUserMessage(anthropic.NewTextBlock("What did I say I work on?")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class AutomaticCachingExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.cacheControl(CacheControlEphemeral.builder().build())
.system("You are a helpful assistant that remembers our conversation.")
.addUserMessage("My name is Alex. I work on machine learning.")
.addAssistantMessage("Nice to meet you, Alex! How can I help with your ML work today?")
.addUserMessage("What did I say I work on?")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
use Anthropic\Messages\CacheControlEphemeral;
// ...
$client = new Client();
$response = $client->messages->create(
maxTokens: 1024,
messages: [
['role' => 'user', 'content' => 'My name is Alex. I work on machine learning.'],
['role' => 'assistant', 'content' => 'Nice to meet you, Alex! How can I help with your ML work today?'],
['role' => 'user', 'content' => 'What did I say I work on?'],
],
model: 'claude-opus-5-5',
cacheControl: CacheControlEphemeral::with(),
system: 'You are a helpful assistant that remembers our conversation.',
);
echo json_encode($response->usage);
```
```ruby Ruby
client = Anthropic::Client.new
response = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
cache_control: {type: "ephemeral"},
system: "You are a helpful assistant that remembers our conversation.",
messages: [
{role: "user", content: "My name is Alex. I work on machine learning."},
{role: "assistant", content: "Nice to meet you, Alex! How can I help with your ML work today?"},
{role: "user", content: "What did I say I work on?"}
]
)
puts response.usage
```
### Como o cache automático funciona em conversas de múltiplos turnos
Com o cache automático, o ponto de cache avança automaticamente à medida que as conversas crescem. Cada nova solicitação armazena em cache tudo até o último bloco que pode ser armazenado em cache, e o conteúdo anterior é lido do cache.
| Solicitação | Conteúdo | Comportamento do cache |
| ------------- | ------------------------------------------------------------------------------------------------------------ | ----------------------------------------------------------------------------- |
| Solicitação 1 | System
+ User(1) + Asst(1)
+ **User(2)** ◀ cache | Tudo é gravado no cache |
| Solicitação 2 | System
+ User(1) + Asst(1)
+ User(2) + Asst(2)
+ **User(3)** ◀ cache | De System até User(2) lido do cache;
Asst(2) + User(3) gravados no cache |
| Solicitação 3 | System
+ User(1) + Asst(1)
+ User(2) + Asst(2)
+ User(3) + Asst(3)
+ **User(4)** ◀ cache | De System até User(3) lido do cache;
Asst(3) + User(4) gravados no cache |
O ponto de interrupção de cache se move automaticamente para o último bloco que pode ser armazenado em cache em cada solicitação, então você não precisa atualizar nenhum marcador `cache_control` à medida que a conversa cresce.
### Suporte a TTL
Por padrão, o cache automático usa um "time to live" (tempo de vida), ou TTL, de 5 minutos. Você pode especificar um TTL de 1 hora por 2x o preço base dos tokens de entrada:
```json
{ "cache_control": { "type": "ephemeral", "ttl": "1h" } }
```
### Combinando com cache em nível de bloco
O cache automático é compatível com [pontos de interrupção de cache explícitos](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#explicit-cache-breakpoints). Quando usados em conjunto, o ponto de interrupção de cache automático ocupa um dos 4 slots de ponto de interrupção disponíveis.
Isso permite combinar as duas abordagens. Por exemplo, use um ponto de interrupção explícito para armazenar em cache seu prompt do sistema, enquanto o cache automático cuida da conversa:
```json
{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"cache_control": { "type": "ephemeral" },
"system": [
{
"type": "text",
"text": "You are a helpful assistant.",
"cache_control": { "type": "ephemeral" }
}
],
"messages": [{ "role": "user", "content": "What are the key terms?" }]
}
```
### O que permanece igual
O cache automático usa a mesma infraestrutura de cache subjacente. Preços, limites mínimos de tokens, requisitos de ordenação de contexto e a janela de retrospecção de 20 blocos se aplicam da mesma forma que com pontos de interrupção explícitos.
### Casos extremos
* Se o último bloco já tiver um `cache_control` explícito com o mesmo TTL, o cache automático não tem efeito.
* Se o último bloco tiver um `cache_control` explícito com um TTL diferente, a API retorna um erro 400.
* Se já existirem 4 pontos de interrupção explícitos em nível de bloco, a API retorna um erro 400 (não há slots restantes para o cache automático).
* Se o último bloco não for elegível como alvo de ponto de interrupção de cache automático, o sistema retrocede silenciosamente para encontrar o bloco elegível mais próximo. Se nenhum for encontrado, o cache é ignorado.
O cache automático está disponível em todas as plataformas, exceto na integração legada [Amazon Bedrock (Opus 4.6 e anteriores)](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-on-amazon-bedrock-legacy). Nessa integração, a API retorna um erro 400 para um campo `cache_control` de nível superior, então use [pontos de interrupção de cache explícitos](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#explicit-cache-breakpoints) em vez disso.
***
## Pontos de interrupção de cache explícitos
Para ter mais controle sobre o cache, você pode colocar `cache_control` diretamente em blocos de conteúdo individuais. Isso é útil quando você precisa armazenar em cache seções diferentes que mudam com frequências diferentes, ou precisa de controle refinado sobre exatamente o que é armazenado em cache.
### Estruturando seu prompt
Coloque o conteúdo estático (definições de ferramentas, instruções do sistema, contexto, exemplos) no início do seu prompt. Marque o fim do conteúdo reutilizável para cache usando o parâmetro `cache_control`.
Os prefixos de cache são criados na seguinte ordem: `tools`, `system` e, em seguida, `messages`. Essa ordem forma uma hierarquia em que cada nível se baseia nos anteriores.
#### Como funciona a verificação automática de prefixos
Você pode usar apenas um ponto de interrupção de cache no fim do seu conteúdo estático, e o sistema encontrará automaticamente o prefixo mais longo que uma solicitação anterior já gravou no cache. Entender como isso funciona ajuda você a otimizar sua estratégia de cache.
**Três princípios fundamentais:**
1. **Gravações em cache acontecem apenas no seu ponto de interrupção.** Marcar um bloco com `cache_control` grava exatamente uma entrada de cache: um hash do prefixo que termina nesse bloco. O sistema não grava entradas para nenhuma posição anterior. Como o hash é cumulativo, cobrindo tudo até o ponto de interrupção, inclusive, alterar qualquer bloco no ponto de interrupção ou antes dele produz um hash diferente na próxima solicitação.
2. **Leituras de cache procuram para trás por entradas que solicitações anteriores gravaram.** Em cada solicitação, o sistema calcula o hash do prefixo no seu ponto de interrupção e verifica se há uma entrada de cache correspondente. Se não houver, ele retrocede um bloco por vez, verificando se o hash do prefixo em cada posição anterior corresponde a algo que já está no cache. Ele procura gravações anteriores, não conteúdo estável.
3. **A "lookback window" (janela de retrospecção) é de 20 blocos.** O sistema verifica no máximo 20 posições por ponto de interrupção, contando o próprio ponto de interrupção como a primeira. Se o sistema não encontrar nenhuma entrada correspondente nessa janela, a verificação para (ou recomeça a partir do próximo ponto de interrupção explícito, se houver). Na Claude API, uma sequência de blocos `tool_use` consecutivos conta como uma posição, assim como uma sequência de blocos `tool_result` consecutivos, de modo que um turno com muitas chamadas de ferramentas paralelas não empurra, por si só, a entrada da solicitação anterior para fora da janela.
**Exemplo: Retrospecção em uma conversa crescente**
Você acrescenta novos blocos a cada turno e define `cache_control` no bloco final de cada solicitação:
* **Turno 1:** 10 blocos, ponto de interrupção no bloco 10. Não existem entradas de cache anteriores. O sistema grava uma entrada no bloco 10.
* **Turno 2:** 15 blocos, ponto de interrupção no bloco 15. O bloco 15 não tem entrada, então o sistema retrocede até o bloco 10 e encontra a entrada do turno 1. Há um "cache hit" (acerto de cache) no bloco 10; o sistema processa do zero apenas os blocos 11 a 15 e grava uma nova entrada no bloco 15.
* **Turno 3:** 35 blocos, ponto de interrupção no bloco 35. O sistema verifica 20 posições (blocos 35 a 16) e não encontra nada. A entrada do turno 2 no bloco 15 está uma posição fora da janela, então não há acerto de cache. Adicionar um segundo ponto de interrupção no bloco 15 inicia ali uma segunda janela de retrospecção, que encontra a entrada do turno 2.
**Erro comum: Ponto de interrupção em conteúdo que muda a cada solicitação**
Seu prompt tem um grande contexto de sistema estático (blocos 1 a 5) seguido por um bloco por solicitação contendo um timestamp e a mensagem do usuário (bloco 6). Você define `cache_control` no bloco 6:
* **Solicitação 1:** Gravação em cache no bloco 6. O hash inclui o timestamp.
* **Solicitação 2:** O timestamp é diferente, então o hash do prefixo no bloco 6 é diferente. A retrospecção percorre os blocos 5, 4, 3, 2 e 1, mas o sistema nunca gravou uma entrada em nenhuma dessas posições. Não há acerto de cache. Você paga por uma nova gravação em cache a cada solicitação e nunca obtém uma leitura.
A retrospecção não encontra conteúdo estável atrás do seu ponto de interrupção para armazená-lo em cache. Ela encontra entradas que solicitações anteriores já gravaram, e as gravações acontecem apenas nos pontos de interrupção. Mova `cache_control` para o bloco 5, o último bloco que permanece igual entre as solicitações, e todas as solicitações subsequentes lerão o prefixo em cache. O [cache automático](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#automatic-caching) cai na mesma armadilha: ele coloca o ponto de interrupção no último bloco que pode ser armazenado em cache, que nessa estrutura é o que muda a cada solicitação, então use um ponto de interrupção explícito no bloco 5 em vez disso.
**Ponto principal:** Coloque `cache_control` no último bloco cujo prefixo é idêntico entre as solicitações que você deseja que compartilhem um cache. Em uma conversa crescente, o bloco final funciona desde que cada turno adicione menos de 20 blocos: o conteúdo anterior nunca muda, então a retrospecção da próxima solicitação encontra a gravação anterior. Para um prompt com um sufixo variável (timestamps, contexto por solicitação, a mensagem recebida), coloque o ponto de interrupção no fim do prefixo estático, não no bloco variável.
#### Quando usar múltiplos pontos de interrupção
Você pode definir até 4 pontos de interrupção de cache se quiser:
* Armazenar em cache seções diferentes que mudam com frequências diferentes (por exemplo, as ferramentas raramente mudam, mas o contexto é atualizado diariamente)
* Ter mais controle sobre exatamente o que é armazenado em cache
* Garantir um acerto de cache quando uma conversa crescente empurra seu ponto de interrupção 20 ou mais blocos além da última gravação em cache
**Limitação importante:** A retrospecção só consegue encontrar entradas que solicitações anteriores já gravaram. Se uma conversa crescente empurrar seu ponto de interrupção 20 ou mais blocos além da última gravação, a janela de retrospecção não a encontrará. Adicione desde o início um segundo ponto de interrupção mais próximo dessa posição, para que uma gravação se acumule ali antes que você precise dela.
### Entendendo os custos dos pontos de interrupção de cache
**Os pontos de interrupção de cache em si não adicionam nenhum custo.** Você é cobrado apenas por:
* **Gravações de cache:** Quando novo conteúdo é gravado no cache (25% a mais que os tokens de entrada base para TTL de 5 minutos)
* **Leituras de cache:** Quando o conteúdo em cache é usado (10% do preço base de tokens de entrada, ou 2,5% no Claude Fable 5.1 e Claude Mythos 5.1, e 5% no Claude Opus 5.5 e Claude Sonnet 5.5)
* **Tokens de entrada regulares:** Para qualquer conteúdo não armazenado em cache
Adicionar mais pontos de interrupção `cache_control` não aumenta seus custos; você continua pagando o mesmo valor com base no conteúdo que é efetivamente armazenado em cache e lido. Os pontos de interrupção dão a você controle sobre quais seções podem ser armazenadas em cache de forma independente.
***
## Estratégias e considerações de cache
### Limitações do cache
Na Claude API, [Claude Platform on AWS](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-platform-on-aws), [Google Cloud](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-on-vertex-ai) e [Microsoft Foundry](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-in-microsoft-foundry), o comprimento mínimo de prompt armazenável em cache é:
* 512 tokens para Claude Fable 5.1, [Claude Mythos 5.1](https://platform.claude.com/docs/pt-BR/models/mythos-5-1/overview), Claude Opus 5.5, Claude Opus 5, Claude Sonnet 5.5, Claude Fable 5, [Claude Mythos 5](https://platform.claude.com/docs/pt-BR/models/mythos-5/overview) e Claude Haiku 5.5
* 2.048 tokens para [Claude Mythos Preview](https://anthropic.com/glasswing) e Claude Opus 4.7
* 4.096 tokens para Claude Opus 4.6 e Claude Opus 4.5
* 1.024 tokens para Claude Opus 4.8, Claude Sonnet 5, Claude Sonnet 4.6, Claude Sonnet 4.5 ([descontinuado](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations)), Claude Opus 4.1 ([desativado, exceto no Bedrock e no Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations)), Claude Opus 4 ([desativado, exceto no Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations)) e Claude Sonnet 4 ([desativado, exceto no Bedrock e no Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations))
* 4.096 tokens para Claude Haiku 4.5
* 2.048 tokens para Claude Haiku 3.5 ([desativado, exceto no Google Cloud](https://platform.claude.com/docs/pt-BR/about-claude/model-deprecations))
Esses mínimos se aplicam em todas as plataformas em que cada modelo está disponível.
Prompts mais curtos não podem ser armazenados em cache, mesmo que marcados com `cache_control`. Quaisquer solicitações para armazenar em cache menos do que esse número de tokens serão processadas sem cache, e nenhum erro é retornado. Para verificar se um prompt foi armazenado em cache, confira os [campos de uso da resposta](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#tracking-cache-performance): se tanto `cache_creation_input_tokens` quanto `cache_read_input_tokens` forem 0, o prompt não foi armazenado em cache (provavelmente porque não atendeu ao requisito de comprimento mínimo).
Se o seu prompt ficar um pouco abaixo do mínimo para o seu modelo e plataforma, expandir o conteúdo em cache para atingir o limite geralmente vale a pena. Leituras de cache custam significativamente menos do que tokens de entrada não armazenados em cache, então atingir o mínimo pode reduzir custos para prompts reutilizados com frequência.
O [Bedrock](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-in-amazon-bedrock) é uma plataforma operada pela AWS. No Bedrock, consulte a [documentação de cache de prompt do Bedrock](https://docs.aws.amazon.com/bedrock/latest/userguide/prompt-caching.html) para os mínimos por modelo, o comportamento em caso de falha e os nomes dos campos de uso aplicáveis.
Para solicitações simultâneas, observe que uma entrada de cache só fica disponível depois que a primeira resposta começa. Se você precisar de acertos de cache para solicitações paralelas, aguarde a primeira resposta antes de enviar as solicitações subsequentes.
Atualmente, "ephemeral" é o único tipo de cache suportado, que por padrão tem um tempo de vida de 5 minutos.
### O que pode ser armazenado em cache
A maioria dos blocos da solicitação pode ser armazenada em cache. Isso inclui:
* Ferramentas: Definições de ferramentas no array `tools`
* Mensagens do sistema: Blocos de conteúdo no array `system`
* Mensagens de texto: Blocos de conteúdo no array `messages.content`, tanto em turnos do usuário quanto do assistente
* Imagens e documentos: Blocos de conteúdo no array `messages.content`, em turnos do usuário
* Uso de ferramentas e resultados de ferramentas: Blocos de conteúdo no array `messages.content`, tanto em turnos do usuário quanto do assistente
Cada um desses elementos pode ser armazenado em cache, seja automaticamente ou marcando-o com `cache_control`.
### O que não pode ser armazenado em cache
Embora a maioria dos blocos da solicitação possa ser armazenada em cache, há algumas exceções:
* Blocos de pensamento não podem ser armazenados em cache diretamente com `cache_control`. No entanto, blocos de pensamento PODEM ser armazenados em cache junto com outro conteúdo quando aparecem em turnos anteriores do assistente. Quando armazenados em cache dessa forma, eles CONTAM como tokens de entrada quando lidos do cache.
* Sub-blocos de conteúdo (como [citações](https://platform.claude.com/docs/pt-BR/build-with-claude/citations)) não podem ser armazenados em cache diretamente. Em vez disso, armazene em cache o bloco de nível superior.
No caso de citações, os blocos de conteúdo de documento de nível superior que servem como material de origem para as citações podem ser armazenados em cache. Isso permite usar o cache de prompt com citações de forma eficaz, armazenando em cache os documentos que as citações referenciarão.
* Blocos de texto vazios não podem ser armazenados em cache.
### O que invalida o cache
Modificações no conteúdo em cache podem invalidar parte ou todo o cache.
Conforme descrito em [Estruturando seu prompt](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#structuring-your-prompt), o cache segue a hierarquia: `tools` → `system` → `messages`. Alterações em cada nível invalidam esse nível e todos os níveis subsequentes.
A tabela a seguir mostra quais partes do cache são invalidadas por diferentes tipos de alterações. ✘ indica que o cache é invalidado, enquanto ✓ indica que o cache permanece válido.
| O que muda | Cache de ferramentas | Cache do sistema | Cache de mensagens | Impacto |
| ----------------------------------------------------------------------------------- | -------------------- | -------------------- | -------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Definições de ferramentas** | ✘ | ✘ | ✘ | Modificar definições de ferramentas (nomes, descrições, parâmetros) invalida o cache inteiro |
| **Ativação da pesquisa na web** | ✓ | ✘ | ✘ | Habilitar/desabilitar a pesquisa na web modifica o prompt do sistema |
| **Ativação de citações** | ✓ | ✘ | ✘ | Habilitar/desabilitar citações modifica o prompt do sistema |
| **Configuração de velocidade** | ✓ | ✘ | ✘ | Alternar entre [`speed: "fast"` e a velocidade padrão](https://platform.claude.com/docs/pt-BR/build-with-claude/fast-mode) invalida os caches do sistema e de mensagens |
| **Escolha de ferramenta** | ✓ | ✓ | ✘ | Alterações no parâmetro `tool_choice` afetam apenas os blocos de mensagens |
| **Imagens** | ✓ | ✓ | ✘ | Adicionar/remover imagens em qualquer lugar do prompt afeta os blocos de mensagens |
| **Parâmetros de pensamento** | Específico do modelo | Específico do modelo | ✘ | A configuração de pensamento (modo e `budget_tokens` no modo estendido) é renderizada no prompt, então alterá-la sempre invalida os blocos de mensagens; os caches de ferramentas e do sistema também são invalidados em modelos que renderizam a configuração antes deles. Consulte [Pensamento e cache de prompt](https://platform.claude.com/docs/pt-BR/build-with-claude/thinking#thinking-and-prompt-caching). |
| **Configuração de esforço** | Específico do modelo | Específico do modelo | ✘ | Alterar o valor de [`output_config.effort`](https://platform.claude.com/docs/pt-BR/build-with-claude/effort) sempre invalida os blocos de mensagens, com o mesmo efeito específico do modelo sobre os caches de ferramentas e do sistema que os parâmetros de pensamento. Definir o esforço explicitamente como o padrão do modelo equivale a omiti-lo e não invalida o cache. Em modelos que suportam [esforço por mensagem](https://platform.claude.com/docs/pt-BR/build-with-claude/effort#change-effort-mid-conversation-beta), uma alteração de esforço transmitida em uma mensagem `role: "system"` dentro de `messages` mantém o prefixo em cache intacto. |
| **Resultados que não são de ferramentas passados para solicitações com pensamento** | ✓ | ✓ | Específico do modelo | No Opus 4.5+, Sonnet 4.6+ e Haiku 5.5, os blocos de pensamento são preservados por padrão, então o cache permanece válido (✓). Em modelos Opus/Sonnet anteriores e modelos Haiku até o Claude Haiku 4.5, todos os blocos de pensamento previamente armazenados em cache são removidos do contexto, e quaisquer mensagens que seguem esses blocos de pensamento são removidas do cache (✘). Para mais detalhes, consulte [Cache com blocos de pensamento](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#caching-with-thinking-blocks). |
| **Blocos de pensamento descartados** | ✓ | ✓ | ✘ | Quando a API descarta um bloco de pensamento do Claude Fable 5.1, Claude Mythos 5.1, Claude Opus 5.5, Claude Sonnet 5.5 ou Claude Haiku 5.5 que não é [preservado](https://platform.claude.com/docs/pt-BR/build-with-claude/thinking#preserved-thinking) nessa solicitação (por exemplo, um que você reenvia para um modelo que não consegue lê-lo), o prefixo em cache muda a partir da posição desse bloco nessa solicitação. Blocos que o modelo receptor consegue ler, devolvidos sem alterações, mantêm o cache intacto. |
Em modelos que suportam [alterações de ferramentas no meio da conversa](https://platform.claude.com/docs/pt-BR/build-with-claude/mid-conversation-system-messages#mid-conversation-tool-changes), o cabeçalho beta `inline-tools-2026-09-15` permite adicionar uma ferramenta, ou alterar a definição de uma ferramenta, no meio de uma conversa sem editar `tools`. Envie a definição em um bloco `tool_addition` em uma mensagem do sistema no meio da conversa e deixe `tools` exatamente como você o enviou pela primeira vez. O prefixo em cache continua correspondendo, então apenas a mensagem acrescentada é processada como nova entrada. A única exceção é um array `tools` sem nenhuma ferramenta não adiada, em que a primeira ferramenta definida dessa forma custa uma falha de cache completa nessa solicitação. Consulte [Definir ferramentas em uma mensagem](https://platform.claude.com/docs/pt-BR/build-with-claude/mid-conversation-system-messages#define-tools-in-a-message-beta).
No Claude Fable 5.1, [Claude Mythos 5.1](https://platform.claude.com/docs/pt-BR/models/mythos-5-1/overview), Claude Fable 5, [Claude Mythos 5](https://platform.claude.com/docs/pt-BR/models/mythos-5/overview), Claude Opus 5.5, Claude Opus 4.8, Claude Opus 5, Claude Sonnet 5.5 e Claude Haiku 5.5, você pode adicionar uma nova instrução do sistema no meio de uma conversa sem invalidar os caches do sistema ou de mensagens. Acrescente uma mensagem `{"role": "system"}` a `messages` em vez de editar o campo `system` de nível superior, para que o prefixo em cache permaneça inalterado. Este recurso não está disponível no Claude Sonnet 5. Use o campo `system` de nível superior em vez disso. Consulte [Mensagens do sistema no meio da conversa](https://platform.claude.com/docs/pt-BR/build-with-claude/mid-conversation-system-messages).
### Acompanhando o desempenho do cache
Monitore o desempenho do cache usando estes campos da resposta da API, dentro de `usage` na resposta (ou no evento `message_start` se estiver usando [streaming](https://platform.claude.com/docs/pt-BR/build-with-claude/streaming)):
* `cache_creation_input_tokens`: Número de tokens gravados no cache ao criar uma nova entrada.
* `cache_read_input_tokens`: Número de tokens recuperados do cache para esta solicitação.
* `input_tokens`: Número de tokens de entrada que não foram lidos do cache nem usados para criar um cache (ou seja, tokens após o último ponto de interrupção de cache).
**Entendendo a divisão de tokens**
O campo `input_tokens` representa apenas os tokens que vêm **após o último ponto de interrupção de cache** na sua solicitação, e não todos os tokens de entrada que você enviou.
Para calcular o total de tokens de entrada:
```text wrap
total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens
```
**Explicação espacial:**
* `cache_read_input_tokens` = tokens antes do ponto de interrupção já em cache (leituras)
* `cache_creation_input_tokens` = tokens antes do ponto de interrupção sendo armazenados em cache agora (gravações)
* `input_tokens` = tokens após seu último ponto de interrupção (não elegíveis para cache)
**Exemplo:** Se você tiver uma solicitação com 100.000 tokens de conteúdo em cache (lidos do cache), 0 tokens de novo conteúdo sendo armazenado em cache e 50 tokens na sua mensagem de usuário (após o ponto de interrupção de cache):
* `cache_read_input_tokens`: 100.000
* `cache_creation_input_tokens`: 0
* `input_tokens`: 50
* **Total de tokens de entrada processados:** 100.050 tokens
Isso é importante para entender tanto os custos quanto os "rate limits" (limites de taxa), já que `input_tokens` normalmente será muito menor do que sua entrada total quando você usa o cache de forma eficaz.
### Cache com blocos de pensamento
Ao usar [pensamento](https://platform.claude.com/docs/pt-BR/build-with-claude/thinking) com cache de prompt, os blocos de pensamento têm um comportamento especial:
**Cache automático junto com outro conteúdo:** Embora os blocos de pensamento não possam ser marcados explicitamente com `cache_control`, eles são armazenados em cache como parte do conteúdo da solicitação quando você faz chamadas de API subsequentes com resultados de ferramentas. Isso geralmente acontece durante o uso de ferramentas, quando você devolve os blocos de pensamento para continuar a conversa.
**Contagem de tokens de entrada:** Quando os blocos de pensamento são lidos do cache, eles contam como tokens de entrada nas suas métricas de uso. Isso é importante para o cálculo de custos e o orçamento de tokens.
**Padrões de invalidação de cache:**
* O cache permanece válido quando apenas resultados de ferramentas são fornecidos como mensagens do usuário
* Nos modelos Opus 4.5+, Sonnet 4.6+ e Haiku 5.5, os blocos de pensamento são preservados por padrão mesmo quando é adicionado conteúdo do usuário que não é resultado de ferramenta, então o cache permanece válido
* Nos modelos Opus/Sonnet anteriores e nos modelos Haiku até o Claude Haiku 4.5, o cache é invalidado quando é adicionado conteúdo do usuário que não é resultado de ferramenta, fazendo com que todos os blocos de pensamento anteriores sejam removidos do contexto
* Esse comportamento de cache ocorre mesmo sem marcadores `cache_control` explícitos
Para mais detalhes sobre a invalidação de cache, consulte [O que invalida o cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#what-invalidates-the-cache).
**Exemplo com uso de ferramentas:**
```text wrap
Request 1: User: "What's the weather in Paris?"
Response: [thinking_block_1] + [tool_use block 1]
Request 2:
User: ["What's the weather in Paris?"],
Assistant: [thinking_block_1] + [tool_use block 1],
User: [tool_result_1, cache=True]
Response: [thinking_block_2] + [text block 2]
# Request 2 caches its request content (not the response)
# The cache includes: user message, thinking_block_1, tool_use block 1, and tool_result_1
Request 3:
User: ["What's the weather in Paris?"],
Assistant: [thinking_block_1] + [tool_use block 1],
User: [tool_result_1, cache=True],
Assistant: [thinking_block_2] + [text block 2],
User: [Text response, cache=True]
# Depending on the model, this non-tool-result user block either keeps prior thinking blocks or strips them (see the next paragraph)
```
Nos modelos Opus/Sonnet anteriores e nos modelos Haiku até o Claude Haiku 4.5, todos os blocos de pensamento anteriores são removidos do contexto neste ponto. Nos modelos Opus 4.5+, Sonnet 4.6+ e Haiku 5.5, os blocos de pensamento anteriores são mantidos por padrão e permanecem como parte do prefixo em cache.
Para informações mais detalhadas, consulte [Pensamento e cache de prompt](https://platform.claude.com/docs/pt-BR/build-with-claude/thinking#thinking-and-prompt-caching).
### Armazenamento e compartilhamento do cache
O cache de prompt usa isolamento em nível de [workspace](https://platform.claude.com/docs/pt-BR/manage-claude/workspaces). Os caches são isolados por workspace, garantindo a separação de dados entre workspaces dentro da mesma organização. Isso se aplica à Claude API, à Claude Platform on AWS e ao Microsoft Foundry; o Bedrock e o Google Cloud mantêm isolamento de cache em nível de organização. Se você usa múltiplos workspaces, revise sua estratégia de cache para levar essa diferença em conta.
* **Isolamento por organização e workspace:** Os caches são isolados entre organizações. Organizações diferentes nunca compartilham caches, mesmo que usem prompts idênticos. Os caches também são isolados por workspace dentro de uma organização na Claude API, na Claude Platform on AWS e no Microsoft Foundry; o Bedrock e o Google Cloud usam apenas isolamento em nível de organização.
* **Correspondência exata:** Acertos de cache exigem segmentos de prompt 100% idênticos, incluindo todo o texto e as imagens até o bloco marcado com controle de cache, inclusive.
* **Geração de tokens de saída:** O cache de prompt não tem efeito sobre a geração de tokens de saída. A resposta que você recebe é idêntica à que você obteria se o cache de prompt não fosse usado.
### Práticas recomendadas para um cache eficaz
Para otimizar o desempenho do cache de prompt:
* Comece com o [cache automático](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#automatic-caching) para conversas de múltiplos turnos. Ele gerencia os pontos de interrupção automaticamente.
* Use [pontos de interrupção explícitos em nível de bloco](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#explicit-cache-breakpoints) quando precisar armazenar em cache seções diferentes com frequências de alteração diferentes.
* Armazene em cache conteúdo estável e reutilizável, como instruções do sistema, informações de base, contextos grandes ou definições de ferramentas frequentes.
* Coloque o conteúdo em cache no início do prompt para obter o melhor desempenho.
* Use pontos de interrupção de cache de forma estratégica para separar diferentes seções de prefixo que podem ser armazenadas em cache.
* Coloque o ponto de interrupção no último bloco que permanece idêntico entre as solicitações. Para um prompt com um prefixo estático e um sufixo variável (timestamps, contexto por solicitação, a mensagem recebida), esse é o fim do prefixo, não o bloco variável.
* Analise regularmente as taxas de acerto de cache e ajuste sua estratégia conforme necessário.
### Otimizando para diferentes casos de uso
Adapte sua estratégia de cache de prompt ao seu cenário:
* Agentes conversacionais: Reduza o custo e a "latency" (latência) em conversas longas, especialmente aquelas com instruções extensas ou documentos enviados.
* Assistentes de programação: Melhore o preenchimento automático e as perguntas e respostas sobre a base de código mantendo no prompt as seções relevantes ou uma versão resumida da base de código.
* Processamento de documentos grandes: Incorpore material completo de formato longo, incluindo imagens, no seu prompt sem aumentar a latência da resposta.
* Conjuntos de instruções detalhadas: Compartilhe listas extensas de instruções, procedimentos e exemplos para ajustar as respostas do Claude. Os desenvolvedores costumam incluir um ou dois exemplos no prompt, mas com o cache de prompt você pode obter um desempenho ainda melhor incluindo mais de 20 exemplos diversos de respostas de alta qualidade.
* Uso de ferramentas agêntico: Melhore o desempenho em cenários que envolvem múltiplas chamadas de ferramentas e alterações iterativas de código, em que cada etapa normalmente exige uma nova chamada de API.
* Converse com livros, artigos, documentação, transcrições de podcasts e outros conteúdos de formato longo: Dê vida a qualquer base de conhecimento incorporando o(s) documento(s) inteiro(s) ao prompt e permitindo que os usuários façam perguntas sobre ele.
### Solução de problemas comuns
Se você estiver enfrentando um comportamento inesperado:
O [diagnóstico de cache](https://platform.claude.com/docs/pt-BR/build-with-claude/cache-diagnostics) faz com que a API compare solicitações consecutivas e informe onde o prefixo do prompt divergiu, o que cuida automaticamente de muitas das etapas desta lista.
* Certifique-se de que as seções em cache sejam idênticas entre as chamadas. Para pontos de interrupção explícitos, verifique se os marcadores `cache_control` estão nos mesmos locais
* Verifique se as chamadas são feitas dentro do tempo de vida do cache (5 minutos por padrão)
* Verifique se `tool_choice`, o uso de imagens, a configuração de pensamento e `output_config.effort` permanecem consistentes entre as chamadas
* Confirme que você está armazenando em cache pelo menos o número mínimo de tokens para o seu modelo e plataforma (consulte [Limitações do cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#cache-limitations))
* Confirme que seu ponto de interrupção está em um bloco que permanece idêntico entre as solicitações. As gravações em cache acontecem apenas no ponto de interrupção e, se esse bloco mudar (timestamps, contexto por solicitação, a mensagem recebida), o hash do prefixo nunca corresponderá. A retrospecção não encontra conteúdo estável atrás do ponto de interrupção; ela só encontra entradas que solicitações anteriores gravaram em seus próprios pontos de interrupção
* Verifique se as chaves nos seus blocos de conteúdo `tool_use` têm ordenação estável, pois algumas linguagens (por exemplo, Swift, Go) tornam aleatória a ordem das chaves durante a conversão para JSON, quebrando os caches
* Use o [diagnóstico de cache](https://platform.claude.com/docs/pt-BR/build-with-claude/cache-diagnostics) para que a API compare solicitações consecutivas e informe qual parte do prompt divergiu
Alterações em `tool_choice` ou a presença/ausência de imagens em qualquer lugar do prompt invalidarão o cache, exigindo a criação de uma nova entrada de cache. Para mais detalhes sobre a invalidação do cache, consulte [O que invalida o cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#what-invalidates-the-cache).
***
## Duração de cache de 1 hora
Se você achar que 5 minutos é pouco tempo, a Anthropic também oferece uma duração de cache de 1 hora [com custo adicional](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#pricing).
A duração de cache de 1 hora está disponível na Claude API, no [Amazon Bedrock](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-in-amazon-bedrock), no [Amazon Bedrock (Opus 4.6 e anteriores)](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-on-amazon-bedrock-legacy), na [Claude Platform on AWS](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-platform-on-aws), no [Google Cloud](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-on-vertex-ai) e no [Microsoft Foundry](https://platform.claude.com/docs/pt-BR/build-with-claude/claude-in-microsoft-foundry).
Para usar o cache estendido, inclua `ttl` na definição de `cache_control` desta forma:
```json
"cache_control": {
"type": "ephemeral",
"ttl": "1h"
}
```
A resposta inclui informações detalhadas de cache como as seguintes:
```json Output
{
"usage": {
"input_tokens": 2048,
"cache_read_input_tokens": 1800,
"cache_creation_input_tokens": 248,
"output_tokens": 503,
"cache_creation": {
"ephemeral_5m_input_tokens": 148,
"ephemeral_1h_input_tokens": 100
}
}
}
```
Observe que o campo atual `cache_creation_input_tokens` é igual à soma dos valores no objeto `cache_creation`.
Se você vir gravações `ephemeral_5m_input_tokens` que não solicitou ao usar ferramentas de servidor, como a pesquisa na web, consulte [Uso de ferramentas com cache de prompt](https://platform.claude.com/docs/pt-BR/agents-and-tools/tool-use/tool-use-with-prompt-caching#server-tool-results-are-cached-automatically).
### Quando usar o cache de 1 hora
Se você tem prompts que são usados em uma cadência regular (ou seja, prompts do sistema usados com mais frequência do que a cada 5 minutos), continue usando o cache de 5 minutos, pois ele continuará sendo renovado sem custo adicional.
O cache de 1 hora é mais indicado nos seguintes cenários:
* Quando você tem prompts que provavelmente são usados com menos frequência do que a cada 5 minutos, mas com mais frequência do que a cada hora. Por exemplo, quando um agente secundário agêntico levará mais de 5 minutos, ou ao armazenar uma longa conversa de chat com um usuário quando você geralmente espera que esse usuário possa não responder nos próximos 5 minutos.
* Quando a latência é importante e seus prompts de acompanhamento podem ser enviados depois de 5 minutos.
* Quando você deseja melhorar a utilização do seu limite de taxa, já que os acertos de cache não são descontados do seu limite de taxa.
Os caches de 5 minutos e de 1 hora se comportam da mesma forma em relação à latência. Em geral, você verá uma melhora no tempo até o primeiro token para documentos longos.
### Misturando TTLs diferentes
Você pode usar controles de cache de 1 hora e de 5 minutos na mesma solicitação, mas com uma restrição importante: entradas de cache com TTL mais longo devem aparecer antes de TTLs mais curtos (ou seja, uma entrada de cache de 1 hora deve aparecer antes de quaisquer entradas de cache de 5 minutos).
Ao misturar TTLs, a API determina três posições de cobrança no seu prompt:
1. Posição `A`: A contagem de tokens no acerto de cache mais alto (ou 0 se não houver acertos).
2. Posição `B`: A contagem de tokens no bloco `cache_control` de 1 hora mais alto após `A` (ou igual a `A` se não existir nenhum).
3. Posição `C`: A contagem de tokens no último bloco `cache_control`.
Se `B` ou `C` for maior que `A`, trata-se necessariamente de uma falha de cache, pois `A` é o acerto de cache mais alto.
Você será cobrado por:
1. Tokens de leitura de cache para `A`.
2. Tokens de escrita de cache de 1 hora para `(B - A)`.
3. Tokens de escrita de cache de 5 minutos para `(C - B)`.
Aqui estão três exemplos. Isto representa os tokens de entrada de 3 solicitações, cada uma com diferentes acertos e falhas de cache. Como resultado, cada uma tem um preço calculado diferente, mostrado nas caixas coloridas.
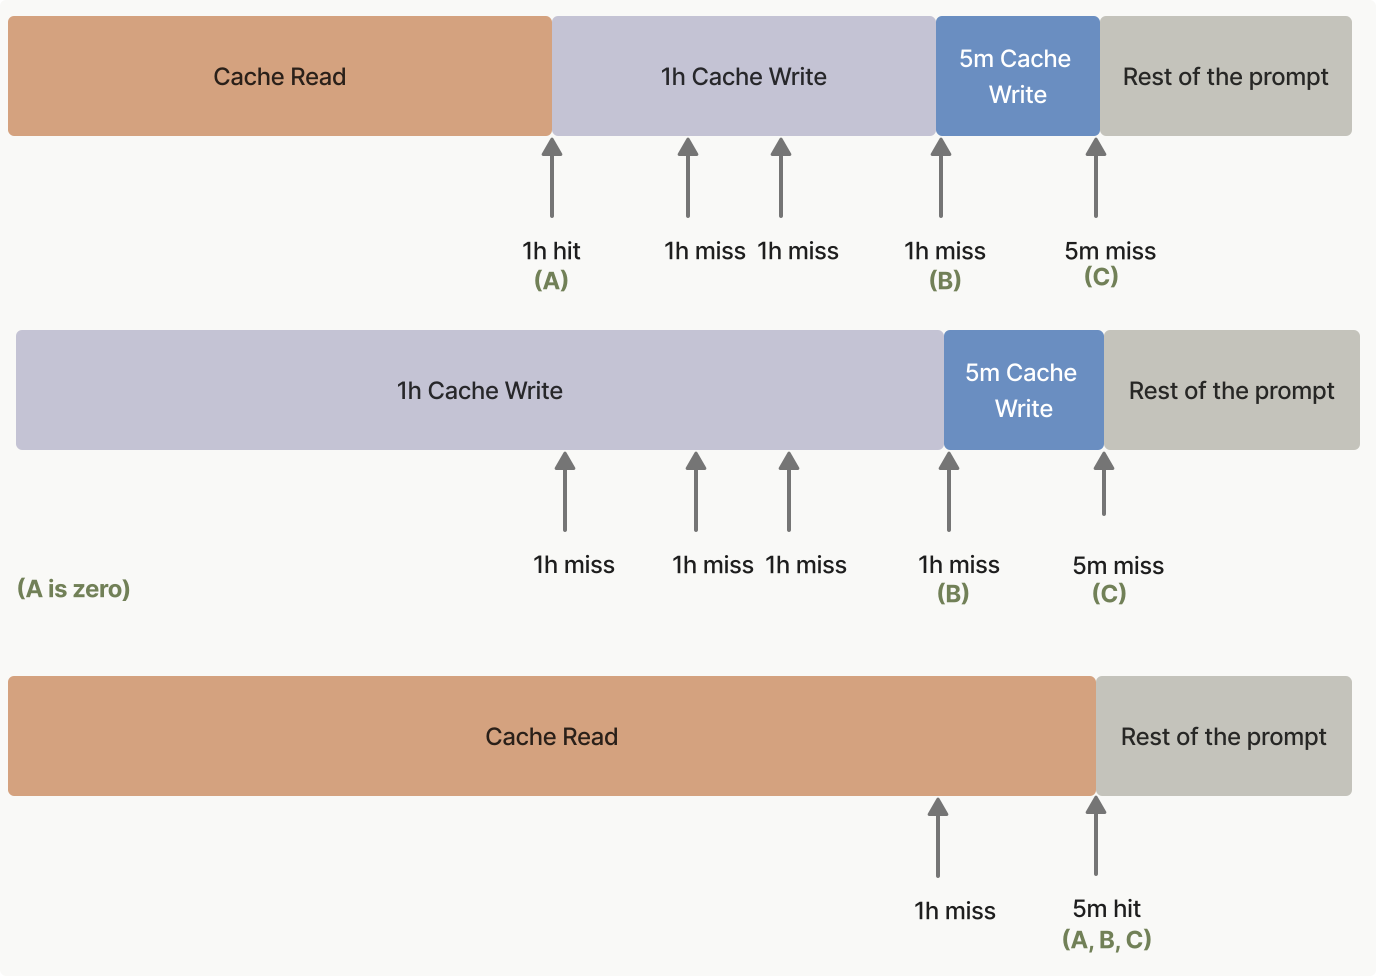
***
## Pré-aquecendo o cache
O "cache pre-warming" (pré-aquecimento do cache) permite que você carregue seu "system prompt" (prompt do sistema) ou suas definições de ferramentas no cache de prompt antes que um usuário dispare uma solicitação real. Isso elimina a penalidade de "latency" (latência) causada pela falha de cache na primeira interação do usuário, reduzindo o "time-to-first-token" (tempo até o primeiro token), ou TTFT, para aplicações sensíveis à latência.
### Como funciona
Defina `max_tokens: 0` na sua solicitação. A API lê seu prompt no modelo e escreve o cache em qualquer "breakpoint" (ponto de interrupção) `cache_control`, e então retorna imediatamente sem gerar nenhuma saída. A resposta tem um array `content` vazio, `stop_reason: "max_tokens"` e um bloco `usage` totalmente preenchido.
Coloque o breakpoint `cache_control` no último bloco que é compartilhado com a solicitação seguinte (normalmente seu prompt do sistema ou suas definições de ferramentas), e não na mensagem de usuário de espaço reservado. Caso contrário, a entrada de cache fica vinculada ao espaço reservado e a solicitação seguinte não a acertará. Use também a mesma configuração de thinking e o mesmo `output_config.effort` das suas solicitações seguintes: esses valores são renderizados no prompt (consulte [O que invalida o cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#what-invalidates-the-cache)), então um pré-aquecimento com uma configuração diferente pode escrever uma entrada que seu tráfego real nunca acerta. Isso significa usar um [breakpoint de cache explícito](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#explicit-cache-breakpoints) em vez do [cache automático](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#automatic-caching), já que o cache automático coloca o breakpoint no último bloco, que aqui é o espaço reservado. A mensagem de usuário de espaço reservado pode ser qualquer string com conteúdo que não seja apenas espaços em branco (os exemplos aqui usam `"warmup"`); seu conteúdo é lido no modelo, mas nunca respondido.
Uma solicitação de pré-aquecimento gera uma cobrança de **escrita de cache** se o prefixo ainda não estiver em cache, assim como qualquer outra solicitação. Verifique `usage.cache_creation_input_tokens` na resposta para confirmar que uma escrita ocorreu. Nenhum token de saída é cobrado.
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 0,
"system": [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [{"role": "user", "content": "warmup"}]
}'
```
```bash CLI
ant messages create \
--transform '{stop_reason,content,usage}' --format yaml <<'YAML'
model: claude-opus-5-5
max_tokens: 0
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: warmup
YAML
```
```python Python
client = anthropic.Anthropic()
# Dispare isto antes da chegada dos usuários para aquecer o cache compartilhado do prompt do sistema.
prewarm = client.messages.create(
model="claude-opus-5-5",
max_tokens=0,
system=[
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"},
}
],
messages=[{"role": "user", "content": "warmup"}],
)
print(prewarm.stop_reason) # "max_tokens"
print(prewarm.content) # []
print(prewarm.usage)
```
```typescript TypeScript
const client = new Anthropic();
// Dispare isto antes da chegada dos usuários para aquecer o cache compartilhado do prompt do sistema.
const prewarm = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 0,
system: [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: { type: "ephemeral" }
}
],
messages: [{ role: "user", content: "warmup" }]
});
console.log(prewarm.stop_reason); // "max_tokens"
console.log(prewarm.content); // []
console.log(prewarm.usage);
```
```csharp C#
AnthropicClient client = new();
var prewarm = await client.Messages.Create(
new()
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 0,
System = new(
[
new TextBlockParam
{
Text = "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl = new(),
},
]
),
Messages = [new() { Role = Role.User, Content = "warmup" }],
}
);
Console.WriteLine(prewarm.StopReason?.Raw()); // "max_tokens"
Console.WriteLine(prewarm.Content.Count); // 0
Console.WriteLine(prewarm.Usage);
```
```go Go
client := anthropic.NewClient()
prewarm, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 0,
System: []anthropic.TextBlockParam{
{
Text: "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("warmup")),
},
})
if err != nil {
panic(err)
}
fmt.Println(prewarm.StopReason) // "max_tokens"
fmt.Println(prewarm.Content) // []
fmt.Println(prewarm.Usage.RawJSON())
```
```java Java
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
Message prewarm = client.messages().create(MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(0)
.systemOfTextBlockParams(List.of(TextBlockParam.builder()
.text("You are an expert software engineer with deep knowledge of distributed systems...")
.cacheControl(CacheControlEphemeral.builder().build())
.build()))
.addUserMessage("warmup")
.build());
IO.println(prewarm.stopReason()); // Optional[max_tokens]
IO.println(prewarm.content()); // []
IO.println(prewarm.usage());
```
```php PHP
$client = new Client();
$prewarm = $client->messages->create(
model: Model::CLAUDE_OPUS_5_5,
maxTokens: 0,
system: [
[
'type' => 'text',
'text' => 'You are an expert software engineer with deep knowledge of distributed systems...',
'cache_control' => ['type' => 'ephemeral'],
],
],
messages: [['role' => 'user', 'content' => 'warmup']],
);
echo $prewarm->stopReason, PHP_EOL; // "max_tokens"
echo json_encode($prewarm->content), PHP_EOL; // []
echo json_encode($prewarm->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
prewarm = client.messages.create(
model: Anthropic::Model::CLAUDE_OPUS_5_5,
max_tokens: 0,
system_: [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: {type: "ephemeral"}
}
],
messages: [{role: "user", content: "warmup"}]
)
puts prewarm.stop_reason # :max_tokens
puts prewarm.content # []
puts prewarm.usage
```
A API retorna um array `content` vazio:
```json Output
{
"id": "msg_01XFDUDYJgAACzvnptvVoYEL",
"type": "message",
"role": "assistant",
"content": [],
"model": "claude-opus-5-5",
"stop_reason": "max_tokens",
"stop_sequence": null,
"usage": {
"input_tokens": 8,
"cache_creation_input_tokens": 5120,
"cache_read_input_tokens": 0,
"cache_creation": {
"ephemeral_5m_input_tokens": 5120,
"ephemeral_1h_input_tokens": 0
},
"iterations": [
{
"input_tokens": 8,
"output_tokens": 0,
"cache_read_input_tokens": 0,
"cache_creation_input_tokens": 5120,
"cache_creation": {
"ephemeral_5m_input_tokens": 5120,
"ephemeral_1h_input_tokens": 0
},
"type": "message"
}
],
"output_tokens": 0,
"service_tier": "standard",
"inference_geo": "global"
}
}
```
### Padrão de uso típico
Dispare uma solicitação de pré-aquecimento quando sua aplicação iniciar (ou em um intervalo agendado) e, em seguida, envie as solicitações reais dos usuários após a conclusão do pré-aquecimento:
```bash cURL
# Aqueça o cache na inicialização da aplicação ou em um intervalo agendado.
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 0,
"system": [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [{"role": "user", "content": "warmup"}]
}'
# Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
curl https://api.anthropic.com/v1/messages \
-H "content-type: application/json" \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"system": [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [{"role": "user", "content": "How do I implement a binary search tree?"}]
}'
```
```bash CLI
# Aqueça o cache na inicialização da aplicação ou em um intervalo agendado.
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 0
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: warmup
YAML
# Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
ant messages create --transform 'content.#(type=="text").text' --raw-output <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: How do I implement a binary search tree?
YAML
```
```python Python
client = anthropic.Anthropic()
SYSTEM_PROMPT = [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"},
}
]
def prewarm_cache() -> None:
"""Call this at application startup or on a scheduled interval."""
client.messages.create(
model="claude-opus-5-5",
max_tokens=0,
system=SYSTEM_PROMPT,
messages=[{"role": "user", "content": "warmup"}],
)
def respond(user_message: str) -> anthropic.types.Message:
"""The real user request; benefits from a warm cache."""
return client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
system=SYSTEM_PROMPT,
messages=[{"role": "user", "content": user_message}],
)
# Aqueça o cache antes que chegue qualquer tráfego de usuários.
prewarm_cache()
# Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
response = respond("How do I implement a binary search tree?")
for block in response.content:
if block.type == "text":
print(block.text)
```
```typescript TypeScript
const client = new Anthropic();
const SYSTEM_PROMPT: Anthropic.TextBlockParam[] = [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: { type: "ephemeral" }
}
];
// Chame isto na inicialização da aplicação ou em um intervalo agendado.
async function prewarmCache(): Promise {
await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 0,
system: SYSTEM_PROMPT,
messages: [{ role: "user", content: "warmup" }]
});
}
// A solicitação real do usuário; se beneficia de um cache já aquecido.
async function respond(userMessage: string): Promise {
return client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
system: SYSTEM_PROMPT,
messages: [{ role: "user", content: userMessage }]
});
}
// Aqueça o cache antes que chegue qualquer tráfego de usuários.
await prewarmCache();
// Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
const response = await respond("How do I implement a binary search tree?");
const textBlock = response.content.find(
(block): block is Anthropic.TextBlock => block.type === "text"
);
console.log(textBlock?.text);
```
```csharp C#
AnthropicClient client = new();
List systemPrompt =
[
new TextBlockParam
{
Text = "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl = new(),
},
];
// Chame isto na inicialização da aplicação ou em um intervalo agendado.
async Task PrewarmCache() =>
await client.Messages.Create(
new()
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 0,
System = new(systemPrompt),
Messages = [new() { Role = Role.User, Content = "warmup" }],
}
);
// A requisição real do usuário; se beneficia de um cache já aquecido.
async Task Respond(string userMessage) =>
await client.Messages.Create(
new()
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
System = new(systemPrompt),
Messages = [new() { Role = Role.User, Content = userMessage }],
}
);
// Aqueça o cache antes que chegue qualquer tráfego de usuários.
await PrewarmCache();
// Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
var response = await Respond("How do I implement a binary search tree?");
foreach (var block in response.Content)
{
if (block.TryPickText(out var textBlock))
{
Console.WriteLine(textBlock.Text);
}
}
```
```go Go
var client = anthropic.NewClient()
var systemPrompt = []anthropic.TextBlockParam{
{
Text: "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
}
// Chame isto na inicialização da aplicação ou em um intervalo agendado.
func prewarmCache() error {
_, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 0,
System: systemPrompt,
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("warmup")),
},
})
return err
}
// A solicitação real do usuário; se beneficia de um cache aquecido.
func respond(userMessage string) (*anthropic.Message, error) {
return client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
System: systemPrompt,
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock(userMessage)),
},
})
}
func main() {
// Aqueça o cache antes que chegue qualquer tráfego de usuários.
if err := prewarmCache(); err != nil {
log.Fatal(err)
}
// Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
response, err := respond("How do I implement a binary search tree?")
if err != nil {
log.Fatal(err)
}
for _, block := range response.Content {
if textBlock, ok := block.AsAny().(anthropic.TextBlock); ok {
fmt.Println(textBlock.Text)
}
}
}
```
```java Java
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
List systemPrompt = List.of(TextBlockParam.builder()
.text("You are an expert software engineer with deep knowledge of distributed systems...")
.cacheControl(CacheControlEphemeral.builder().build())
.build());
// Chame isto na inicialização da aplicação ou em um intervalo agendado.
void prewarmCache() {
client.messages().create(MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(0)
.systemOfTextBlockParams(systemPrompt)
.addUserMessage("warmup")
.build());
}
// A solicitação real do usuário; se beneficia de um cache aquecido.
Message respond(String userMessage) {
return client.messages().create(MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(systemPrompt)
.addUserMessage(userMessage)
.build());
}
void main() {
// Aqueça o cache antes que chegue qualquer tráfego de usuários.
prewarmCache();
// Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
Message response = respond("How do I implement a binary search tree?");
response.content().stream()
.flatMap(block -> block.text().stream())
.forEach(textBlock -> IO.println(textBlock.text()));
}
```
```php PHP
$client = new Client();
$systemPrompt = [
[
'type' => 'text',
'text' => 'You are an expert software engineer with deep knowledge of distributed systems...',
'cache_control' => ['type' => 'ephemeral'],
],
];
// Chame isto na inicialização da aplicação ou em um intervalo agendado.
$prewarmCache = fn () => $client->messages->create(
model: Model::CLAUDE_OPUS_5_5,
maxTokens: 0,
system: $systemPrompt,
messages: [['role' => 'user', 'content' => 'warmup']],
);
// A requisição real do usuário; se beneficia de um cache já aquecido.
$respond = fn (string $userMessage) => $client->messages->create(
model: Model::CLAUDE_OPUS_5_5,
maxTokens: 1024,
system: $systemPrompt,
messages: [['role' => 'user', 'content' => $userMessage]],
);
// Aqueça o cache antes que chegue qualquer tráfego de usuários.
$prewarmCache();
// Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
$response = $respond('How do I implement a binary search tree?');
foreach ($response->content as $block) {
if ($block->type === 'text') {
echo $block->text, PHP_EOL;
}
}
```
```ruby Ruby
client = Anthropic::Client.new
SYSTEM_PROMPT = [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: {type: "ephemeral"}
}
]
# Chame isto na inicialização da aplicação ou em um intervalo agendado.
def prewarm_cache(client)
client.messages.create(
model: Anthropic::Model::CLAUDE_OPUS_5_5,
max_tokens: 0,
system_: SYSTEM_PROMPT,
messages: [{role: "user", content: "warmup"}]
)
end
# A solicitação real do usuário; se beneficia de um cache já aquecido.
def respond(client, user_message)
client.messages.create(
model: Anthropic::Model::CLAUDE_OPUS_5_5,
max_tokens: 1024,
system_: SYSTEM_PROMPT,
messages: [{role: "user", content: user_message}]
)
end
# Aqueça o cache antes que chegue qualquer tráfego de usuários.
prewarm_cache(client)
# Depois, quando o usuário enviar uma mensagem, o prefixo do prompt do sistema já estará em cache.
response = respond(client, "How do I implement a binary search tree?")
response.content.each do |block|
puts block.text if block.type == :text
end
```
Lembre-se de que o TTL do cache continua se aplicando. Para o cache padrão de 5 minutos, envie uma nova solicitação de pré-aquecimento pelo menos a cada 5 minutos para manter o cache aquecido. Para intervalos mais longos entre as solicitações dos usuários, use a [duração de cache de 1 hora](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#1-hour-cache-duration).
### Limitações
Uma solicitação com `max_tokens: 0` é rejeitada com um `invalid_request_error` se qualquer um dos itens a seguir estiver definido, já que cada um implica uma saída que um orçamento de zero tokens não pode produzir:
* `stream: true`
* ["Extended thinking" (pensamento estendido)](https://platform.claude.com/docs/pt-BR/build-with-claude/extended-thinking) (`thinking.type: "enabled"`)
* [Saídas estruturadas](https://platform.claude.com/docs/pt-BR/build-with-claude/structured-outputs) (`output_config.format`)
* `tool_choice` de `{"type": "tool", ...}` ou `{"type": "any"}`
`max_tokens: 0` também é rejeitado dentro de uma solicitação de [Message Batches](https://platform.claude.com/docs/pt-BR/build-with-claude/batch-processing). O pré-aquecimento visa o tempo até o primeiro token, o que não se aplica ao processamento em lote, e uma entrada de cache escrita durante o processamento em lote provavelmente expiraria antes da execução da solicitação seguinte.
### Substituindo a solução alternativa max\_tokens=1
Antes de `max_tokens: 0` estar disponível, algumas aplicações usavam chamadas de aquecimento com `max_tokens: 1` para obter o mesmo efeito. A abordagem com `max_tokens: 0` é preferível: nenhuma saída é produzida, então não há resposta de um único token para descartar, nenhum token de saída é cobrado e a intenção da solicitação é inequívoca.
***
## Exemplos de cache de prompt
Para ajudar você a começar com o "prompt caching" (cache de prompt), o [cookbook de cache de prompt](https://platform.claude.com/cookbook/misc-prompt-caching) fornece exemplos detalhados e boas práticas.
Os trechos de código a seguir mostram vários padrões de cache de prompt. Esses exemplos demonstram como implementar o cache em diferentes cenários, ajudando você a entender as aplicações práticas desse recurso:
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-H "content-type: application/json" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"system": [
{
"type": "text",
"text": "You are an AI assistant tasked with analyzing legal documents."
},
{
"type": "text",
"text": "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [
{
"role": "user",
"content": "What are the key terms and conditions in this agreement?"
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
system:
- type: text
text: You are an AI assistant tasked with analyzing legal documents.
- type: text
text: >-
Here is the full text of a complex legal agreement:
[Insert full text of a 50-page legal agreement here]
cache_control:
type: ephemeral
messages:
- role: user
content: What are the key terms and conditions in this agreement?
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
system=[
{
"type": "text",
"text": "You are an AI assistant tasked with analyzing legal documents.",
},
{
"type": "text",
"text": "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
"cache_control": {"type": "ephemeral"},
},
],
messages=[
{
"role": "user",
"content": "What are the key terms and conditions in this agreement?",
}
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "You are an AI assistant tasked with analyzing legal documents."
},
{
type: "text",
text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "What are the key terms and conditions in this agreement?"
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new()
{
ApiKey = Environment.GetEnvironmentVariable("ANTHROPIC_API_KEY")
};
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
System = new MessageCreateParamsSystem(new List
{
new TextBlockParam()
{
Text = "You are an AI assistant tasked with analyzing legal documents.",
},
new TextBlockParam()
{
Text = "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new()
{
Role = Role.User,
Content = "What are the key terms and conditions in this agreement?"
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
System: []anthropic.TextBlockParam{
{
Text: "You are an AI assistant tasked with analyzing legal documents.",
},
{
Text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("What are the key terms and conditions in this agreement?")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class LegalDocumentAnalysisExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(
List.of(
TextBlockParam.builder()
.text("You are an AI assistant tasked with analyzing legal documents.")
.build(),
TextBlockParam.builder()
.text(
"Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
.addUserMessage("What are the key terms and conditions in this agreement?")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
$client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => 'What are the key terms and conditions in this agreement?'
]
],
model: 'claude-opus-5-5',
system: [
[
'type' => 'text',
'text' => 'You are an AI assistant tasked with analyzing legal documents.'
],
[
'type' => 'text',
'text' => 'Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]',
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
message = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "You are an AI assistant tasked with analyzing legal documents."
},
{
type: "text",
text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "What are the key terms and conditions in this agreement?"
}
]
)
puts message.usage
```
Este exemplo demonstra o uso básico do cache de prompt, armazenando em cache o texto completo do contrato jurídico como prefixo, enquanto mantém a instrução do usuário fora do cache.
Para a primeira solicitação:
* `input_tokens`: Número de tokens apenas na mensagem do usuário
* `cache_creation_input_tokens`: Número de tokens em toda a mensagem do sistema, incluindo o documento jurídico
* `cache_read_input_tokens`: 0 (nenhum acerto de cache na primeira solicitação)
Para solicitações subsequentes dentro do tempo de vida do cache:
* `input_tokens`: Número de tokens apenas na mensagem do usuário
* `cache_creation_input_tokens`: 0 (nenhuma nova criação de cache)
* `cache_read_input_tokens`: Número de tokens em toda a mensagem do sistema armazenada em cache
As definições de ferramentas podem ser armazenadas em cache colocando `cache_control` na última ferramenta do seu array `tools`. Todas as ferramentas definidas antes dessa ferramenta, incluindo ela, são armazenadas em cache como um único prefixo.
```json
{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"tools": [
{
"name": "get_weather",
"description": "Get the current weather in a given location",
"input_schema": {
"type": "object",
"properties": { "location": { "type": "string" } },
"required": ["location"]
}
},
{
"name": "get_time",
"description": "Get the current time in a given time zone",
"input_schema": {
"type": "object",
"properties": { "timezone": { "type": "string" } },
"required": ["timezone"]
},
"cache_control": { "type": "ephemeral" }
}
],
"messages": [{ "role": "user", "content": "What is the weather and time in New York?" }]
}
```
Na primeira solicitação, `cache_creation_input_tokens` reflete a contagem de tokens de todas as definições de ferramentas. Em solicitações subsequentes dentro do tempo de vida do cache, esses tokens aparecem em `cache_read_input_tokens`.
Para detalhes sobre a interação entre definições de ferramentas, `defer_loading` e invalidação de cache, consulte ["Tool use" (uso de ferramentas) com cache de prompt](https://platform.claude.com/docs/pt-BR/agents-and-tools/tool-use/tool-use-with-prompt-caching).
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-H "content-type: application/json" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"system": [
{
"type": "text",
"text": "...long system prompt",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [
{
"role": "user",
"content": [
{
"type": "text",
"text": "Hello, can you tell me more about the solar system?"
}
]
},
{
"role": "assistant",
"content": "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
{
"role": "user",
"content": [
{
"type": "text",
"text": "Good to know."
},
{
"type": "text",
"text": "Tell me more about Mars.",
"cache_control": {"type": "ephemeral"}
}
]
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
system:
- type: text
text: "...long system prompt"
cache_control:
type: ephemeral
messages:
- role: user
content:
- type: text
text: Hello, can you tell me more about the solar system?
- role: assistant
content: >-
Certainly! The solar system is the collection of celestial bodies that
orbit our Sun. It consists of eight planets, numerous moons, asteroids,
comets, and other objects. The planets, in order from closest to farthest
from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus,
and Neptune. Each planet has its own unique characteristics and features.
Is there a specific aspect of the solar system you would like to know
more about?
- role: user
content:
- type: text
text: Good to know.
- type: text
text: Tell me more about Mars.
cache_control:
type: ephemeral
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
system=[
{
"type": "text",
"text": "...long system prompt",
"cache_control": {"type": "ephemeral"},
}
],
messages=[
# ...conversa longa até aqui
{
"role": "user",
"content": [
{
"type": "text",
"text": "Hello, can you tell me more about the solar system?",
}
],
},
{
"role": "assistant",
"content": "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you'd like to know more about?",
},
{
"role": "user",
"content": [
{"type": "text", "text": "Good to know."},
{
"type": "text",
"text": "Tell me more about Mars.",
"cache_control": {"type": "ephemeral"},
},
],
},
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "...long system prompt",
cache_control: { type: "ephemeral" }
}
],
messages: [
// ...conversa longa até aqui
{
role: "user",
content: [
{
type: "text",
text: "Hello, can you tell me more about the solar system?"
}
]
},
{
role: "assistant",
content:
"Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you'd like to know more about?"
},
{
role: "user",
content: [
{
type: "text",
text: "Good to know."
},
{
type: "text",
text: "Tell me more about Mars.",
cache_control: { type: "ephemeral" }
}
]
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
System = new MessageCreateParamsSystem(new List
{
new TextBlockParam()
{
Text = "...long system prompt",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new TextBlockParam("Hello, can you tell me more about the solar system?")),
}),
},
new()
{
Role = Role.Assistant,
Content = "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new TextBlockParam("Good to know.")),
new ContentBlockParam(new TextBlockParam()
{
Text = "Tell me more about Mars.",
CacheControl = new CacheControlEphemeral(),
}),
})
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
System: []anthropic.TextBlockParam{
{
Text: "...long system prompt",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("Hello, can you tell me more about the solar system?")),
anthropic.NewAssistantMessage(anthropic.NewTextBlock("Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?")),
{
Role: anthropic.MessageParamRoleUser,
Content: []anthropic.ContentBlockParamUnion{
anthropic.NewTextBlock("Good to know."),
{OfText: &anthropic.TextBlockParam{
Text: "Tell me more about Mars.",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
}},
},
},
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class ConversationWithCacheControlExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
// Cria o prompt do sistema efêmero
TextBlockParam systemPrompt = TextBlockParam.builder()
.text("...long system prompt")
.cacheControl(CacheControlEphemeral.builder().build())
.build();
// Cria os parâmetros da mensagem
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(List.of(systemPrompt))
// Primeira mensagem do usuário (sem controle de cache)
.addUserMessage("Hello, can you tell me more about the solar system?")
// Resposta do assistente
.addAssistantMessage(
"Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
)
// Segunda mensagem do usuário (com controle de cache)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(TextBlockParam.builder().text("Good to know.").build()),
ContentBlockParam.ofText(
TextBlockParam.builder()
.text("Tell me more about Mars.")
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
)
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
$client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => [
[
'type' => 'text',
'text' => 'Hello, can you tell me more about the solar system?'
]
]
],
[
'role' => 'assistant',
'content' => "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
],
[
'role' => 'user',
'content' => [
['type' => 'text', 'text' => 'Good to know.'],
[
'type' => 'text',
'text' => 'Tell me more about Mars.',
'cache_control' => ['type' => 'ephemeral']
]
]
]
],
model: 'claude-opus-5-5',
system: [
[
'type' => 'text',
'text' => '...long system prompt',
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
message = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "...long system prompt",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: [
{
type: "text",
text: "Hello, can you tell me more about the solar system?"
}
]
},
{
role: "assistant",
content: "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
{
role: "user",
content: [
{ type: "text", text: "Good to know." },
{
type: "text",
text: "Tell me more about Mars.",
cache_control: { type: "ephemeral" }
}
]
}
]
)
puts message.usage
```
Este exemplo demonstra como usar o cache de prompt em uma conversa de múltiplos turnos.
Durante cada turno, o bloco final da mensagem final é marcado com `cache_control` para que a conversa possa ser armazenada em cache de forma incremental. O sistema procura e usa automaticamente a sequência mais longa de blocos previamente armazenada em cache para as mensagens seguintes. Ou seja, blocos que foram previamente marcados com um bloco `cache_control` não são marcados com ele posteriormente, mas ainda serão considerados um acerto de cache (e também uma renovação do cache!) se forem acertados dentro de 5 minutos.
Além disso, observe que o parâmetro `cache_control` é colocado na mensagem do sistema. Isso garante que, se ela for removida do cache (após não ser usada por mais de 5 minutos), ela será adicionada de volta ao cache na próxima solicitação.
Essa abordagem é útil para manter o contexto em conversas contínuas sem processar repetidamente as mesmas informações.
Quando isso estiver configurado corretamente, você deverá ver o seguinte na resposta de uso de cada solicitação:
* `input_tokens`: Número de tokens na nova mensagem do usuário (será mínimo)
* `cache_creation_input_tokens`: Número de tokens nos novos turnos do assistente e do usuário
* `cache_read_input_tokens`: Número de tokens na conversa até o turno anterior
```bash cURL
curl https://api.anthropic.com/v1/messages \
-H "x-api-key: $ANTHROPIC_API_KEY" \
-H "anthropic-version: 2023-06-01" \
-H "content-type: application/json" \
-d '{
"model": "claude-opus-5-5",
"max_tokens": 1024,
"tools": [
{
"name": "search_documents",
"description": "Search through the knowledge base",
"input_schema": {
"type": "object",
"properties": {
"query": {
"type": "string",
"description": "Search query"
}
},
"required": ["query"]
}
},
{
"name": "get_document",
"description": "Retrieve a specific document by ID",
"input_schema": {
"type": "object",
"properties": {
"doc_id": {
"type": "string",
"description": "Document ID"
}
},
"required": ["doc_id"]
},
"cache_control": {"type": "ephemeral"}
}
],
"system": [
{
"type": "text",
"text": "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
"cache_control": {"type": "ephemeral"}
},
{
"type": "text",
"text": "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
"cache_control": {"type": "ephemeral"}
}
],
"messages": [
{
"role": "user",
"content": "Can you search for information about Mars rovers?"
},
{
"role": "assistant",
"content": [
{
"type": "tool_use",
"id": "tool_1",
"name": "search_documents",
"input": {"query": "Mars rovers"}
}
]
},
{
"role": "user",
"content": [
{
"type": "tool_result",
"tool_use_id": "tool_1",
"content": "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
"role": "assistant",
"content": [
{
"type": "text",
"text": "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
"role": "user",
"content": [
{
"type": "text",
"text": "Yes, please tell me about the Perseverance rover specifically.",
"cache_control": {"type": "ephemeral"}
}
]
}
]
}'
```
```bash CLI
ant messages create --transform usage <<'YAML'
model: claude-opus-5-5
max_tokens: 1024
tools:
- name: search_documents
description: Search through the knowledge base
input_schema:
type: object
properties:
query:
type: string
description: Search query
required: [query]
- name: get_document
description: Retrieve a specific document by ID
input_schema:
type: object
properties:
doc_id:
type: string
description: Document ID
required: [doc_id]
cache_control:
type: ephemeral
system:
- type: text
text: |-
You are a helpful research assistant with access to a document knowledge base.
# Instructions
- Always search for relevant documents before answering
- Provide citations for your sources
- Be objective and accurate in your responses
- If multiple documents contain relevant information, synthesize them
- Acknowledge when information is not available in the knowledge base
cache_control:
type: ephemeral
- type: text
text: |-
# Knowledge Base Context
Here are the relevant documents for this conversation:
## Document 1: Solar System Overview
The solar system consists of the Sun and all objects that orbit it...
## Document 2: Planetary Characteristics
Each planet has unique features. Mercury is the smallest planet...
## Document 3: Mars Exploration
Mars has been a target of exploration for decades...
[Additional documents...]
cache_control:
type: ephemeral
messages:
- role: user
content: Can you search for information about Mars rovers?
- role: assistant
content:
- type: tool_use
id: tool_1
name: search_documents
input:
query: Mars rovers
- role: user
content:
- type: tool_result
tool_use_id: tool_1
content: >-
Found 3 relevant documents: Document 3 (Mars Exploration),
Document 7 (Rover Technology), Document 9 (Mission History)
- role: assistant
content:
- type: text
text: >-
I found 3 relevant documents about Mars rovers. Let me get more
details from the Mars Exploration document.
- role: user
content:
- type: text
text: Yes, please tell me about the Perseverance rover specifically.
cache_control:
type: ephemeral
YAML
```
```python Python
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=1024,
tools=[
{
"name": "search_documents",
"description": "Search through the knowledge base",
"input_schema": {
"type": "object",
"properties": {
"query": {"type": "string", "description": "Search query"}
},
"required": ["query"],
},
},
{
"name": "get_document",
"description": "Retrieve a specific document by ID",
"input_schema": {
"type": "object",
"properties": {
"doc_id": {"type": "string", "description": "Document ID"}
},
"required": ["doc_id"],
},
"cache_control": {"type": "ephemeral"},
},
],
system=[
{
"type": "text",
"text": "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
"cache_control": {"type": "ephemeral"},
},
{
"type": "text",
"text": "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
"cache_control": {"type": "ephemeral"},
},
],
messages=[
{
"role": "user",
"content": "Can you search for information about Mars rovers?",
},
{
"role": "assistant",
"content": [
{
"type": "tool_use",
"id": "tool_1",
"name": "search_documents",
"input": {"query": "Mars rovers"},
}
],
},
{
"role": "user",
"content": [
{
"type": "tool_result",
"tool_use_id": "tool_1",
"content": "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
}
],
},
{
"role": "assistant",
"content": [
{
"type": "text",
"text": "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.",
}
],
},
{
"role": "user",
"content": [
{
"type": "text",
"text": "Yes, please tell me about the Perseverance rover specifically.",
"cache_control": {"type": "ephemeral"},
}
],
},
],
)
print(response.usage.model_dump_json())
```
```typescript TypeScript
const client = new Anthropic();
const response = await client.messages.create({
model: "claude-opus-5-5",
max_tokens: 1024,
tools: [
{
name: "search_documents",
description: "Search through the knowledge base",
input_schema: {
type: "object",
properties: {
query: {
type: "string",
description: "Search query"
}
},
required: ["query"]
}
},
{
name: "get_document",
description: "Retrieve a specific document by ID",
input_schema: {
type: "object",
properties: {
doc_id: {
type: "string",
description: "Document ID"
}
},
required: ["doc_id"]
},
cache_control: { type: "ephemeral" }
}
],
system: [
{
type: "text",
text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
cache_control: { type: "ephemeral" }
},
{
type: "text",
text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "Can you search for information about Mars rovers?"
},
{
role: "assistant",
content: [
{
type: "tool_use",
id: "tool_1",
name: "search_documents",
input: { query: "Mars rovers" }
}
]
},
{
role: "user",
content: [
{
type: "tool_result",
tool_use_id: "tool_1",
content:
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
role: "assistant",
content: [
{
type: "text",
text: "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
role: "user",
content: [
{
type: "text",
text: "Yes, please tell me about the Perseverance rover specifically.",
cache_control: { type: "ephemeral" }
}
]
}
]
});
console.log(response.usage);
```
```csharp C#
AnthropicClient client = new()
{
ApiKey = Environment.GetEnvironmentVariable("ANTHROPIC_API_KEY")
};
var parameters = new MessageCreateParams
{
Model = Model.ClaudeOpus5_5,
MaxTokens = 1024,
Tools =
[
new ToolUnion(new Tool()
{
Name = "search_documents",
Description = "Search through the knowledge base",
InputSchema = new InputSchema()
{
Properties = new Dictionary
{
["query"] = JsonSerializer.SerializeToElement(new { type = "string", description = "Search query" }),
},
Required = ["query"],
},
}),
new ToolUnion(new Tool()
{
Name = "get_document",
Description = "Retrieve a specific document by ID",
InputSchema = new InputSchema()
{
Properties = new Dictionary
{
["doc_id"] = JsonSerializer.SerializeToElement(new { type = "string", description = "Document ID" }),
},
Required = ["doc_id"],
},
CacheControl = new CacheControlEphemeral(),
}),
],
System = new MessageCreateParamsSystem(new List
{
new TextBlockParam()
{
Text = "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
CacheControl = new CacheControlEphemeral(),
},
new TextBlockParam()
{
Text = "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new() { Role = Role.User, Content = "Can you search for information about Mars rovers?" },
new()
{
Role = Role.Assistant,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new ToolUseBlockParam()
{
ID = "tool_1",
Name = "search_documents",
Input = new Dictionary
{
["query"] = JsonSerializer.SerializeToElement("Mars rovers"),
},
}),
}),
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new ToolResultBlockParam()
{
ToolUseID = "tool_1",
Content = "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
}),
}),
},
new()
{
Role = Role.Assistant,
Content = "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.",
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List
{
new ContentBlockParam(new TextBlockParam()
{
Text = "Yes, please tell me about the Perseverance rover specifically.",
CacheControl = new CacheControlEphemeral(),
}),
}),
},
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage);
```
```go Go
client := anthropic.NewClient()
response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
Model: anthropic.ModelClaudeOpus5_5,
MaxTokens: 1024,
Tools: []anthropic.ToolUnionParam{
{OfTool: &anthropic.ToolParam{
Name: "search_documents",
Description: anthropic.String("Search through the knowledge base"),
InputSchema: anthropic.ToolInputSchemaParam{
Properties: map[string]any{
"query": map[string]any{
"type": "string",
"description": "Search query",
},
},
Required: []string{"query"},
},
}},
{OfTool: &anthropic.ToolParam{
Name: "get_document",
Description: anthropic.String("Retrieve a specific document by ID"),
InputSchema: anthropic.ToolInputSchemaParam{
Properties: map[string]any{
"doc_id": map[string]any{
"type": "string",
"description": "Document ID",
},
},
Required: []string{"doc_id"},
},
CacheControl: anthropic.NewCacheControlEphemeralParam(),
}},
},
System: []anthropic.TextBlockParam{
{
Text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
{
Text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
},
},
Messages: []anthropic.MessageParam{
anthropic.NewUserMessage(anthropic.NewTextBlock("Can you search for information about Mars rovers?")),
anthropic.NewAssistantMessage(anthropic.NewToolUseBlock(
"tool_1",
map[string]any{"query": "Mars rovers"},
"search_documents",
)),
anthropic.NewUserMessage(anthropic.NewToolResultBlock(
"tool_1",
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
false,
)),
anthropic.NewAssistantMessage(anthropic.NewTextBlock("I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.")),
{
Role: anthropic.MessageParamRoleUser,
Content: []anthropic.ContentBlockParamUnion{
{OfText: &anthropic.TextBlockParam{
Text: "Yes, please tell me about the Perseverance rover specifically.",
CacheControl: anthropic.NewCacheControlEphemeralParam(),
}},
},
},
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON())
```
```java Java
import com.anthropic.models.messages.CacheControlEphemeral;
// ...
public class MultipleCacheBreakpointsExample {
public static void main(String[] args) {
AnthropicClient client = AnthropicOkHttpClient.fromEnv();
// Schema da ferramenta de busca
InputSchema searchSchema = InputSchema.builder()
.properties(
JsonValue.from(
Map.of("query", Map.of("type", "string", "description", "Search query"))
)
)
.putAdditionalProperty("required", JsonValue.from(List.of("query")))
.build();
// Schema da ferramenta de obtenção de documento
InputSchema getDocSchema = InputSchema.builder()
.properties(
JsonValue.from(
Map.of("doc_id", Map.of("type", "string", "description", "Document ID"))
)
)
.putAdditionalProperty("required", JsonValue.from(List.of("doc_id")))
.build();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.CLAUDE_OPUS_5_5)
.maxTokens(1024)
// Ferramentas com cache control na última
.addTool(
Tool.builder()
.name("search_documents")
.description("Search through the knowledge base")
.inputSchema(searchSchema)
.build()
)
.addTool(
Tool.builder()
.name("get_document")
.description("Retrieve a specific document by ID")
.inputSchema(getDocSchema)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
// Prompts do sistema com cache control separado nas instruções e no contexto
.systemOfTextBlockParams(
List.of(
TextBlockParam.builder()
.text(
"You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build(),
TextBlockParam.builder()
.text(
"# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
// Histórico da conversa
.addUserMessage("Can you search for information about Mars rovers?")
.addAssistantMessageOfBlockParams(
List.of(
ContentBlockParam.ofToolUse(
ToolUseBlockParam.builder()
.id("tool_1")
.name("search_documents")
.input(JsonValue.from(Map.of("query", "Mars rovers")))
.build()
)
)
)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofToolResult(
ToolResultBlockParam.builder()
.toolUseId("tool_1")
.content(
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
)
.build()
)
)
)
.addAssistantMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(
TextBlockParam.builder()
.text(
"I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
)
.build()
)
)
)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(
TextBlockParam.builder()
.text("Yes, please tell me about the Perseverance rover specifically.")
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
)
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
}
```
```php PHP
$client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => 'Can you search for information about Mars rovers?'
],
[
'role' => 'assistant',
'content' => [
[
'type' => 'tool_use',
'id' => 'tool_1',
'name' => 'search_documents',
'input' => ['query' => 'Mars rovers']
]
]
],
[
'role' => 'user',
'content' => [
[
'type' => 'tool_result',
'tool_use_id' => 'tool_1',
'content' => 'Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)'
]
]
],
[
'role' => 'assistant',
'content' => [
[
'type' => 'text',
'text' => 'I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.'
]
]
],
[
'role' => 'user',
'content' => [
[
'type' => 'text',
'text' => 'Yes, please tell me about the Perseverance rover specifically.',
'cache_control' => ['type' => 'ephemeral']
]
]
]
],
model: 'claude-opus-5-5',
system: [
[
'type' => 'text',
'text' => "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
'cache_control' => ['type' => 'ephemeral']
],
[
'type' => 'text',
'text' => "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
'cache_control' => ['type' => 'ephemeral']
]
],
tools: [
[
'name' => 'search_documents',
'description' => 'Search through the knowledge base',
'input_schema' => [
'type' => 'object',
'properties' => [
'query' => [
'type' => 'string',
'description' => 'Search query'
]
],
'required' => ['query']
]
],
[
'name' => 'get_document',
'description' => 'Retrieve a specific document by ID',
'input_schema' => [
'type' => 'object',
'properties' => [
'doc_id' => [
'type' => 'string',
'description' => 'Document ID'
]
],
'required' => ['doc_id']
],
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL;
```
```ruby Ruby
client = Anthropic::Client.new
message = client.messages.create(
model: "claude-opus-5-5",
max_tokens: 1024,
tools: [
{
name: "search_documents",
description: "Search through the knowledge base",
input_schema: {
type: "object",
properties: {
query: {
type: "string",
description: "Search query"
}
},
required: ["query"]
}
},
{
name: "get_document",
description: "Retrieve a specific document by ID",
input_schema: {
type: "object",
properties: {
doc_id: {
type: "string",
description: "Document ID"
}
},
required: ["doc_id"]
},
cache_control: { type: "ephemeral" }
}
],
system: [
{
type: "text",
text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
cache_control: { type: "ephemeral" }
},
{
type: "text",
text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "Can you search for information about Mars rovers?"
},
{
role: "assistant",
content: [
{
type: "tool_use",
id: "tool_1",
name: "search_documents",
input: { query: "Mars rovers" }
}
]
},
{
role: "user",
content: [
{
type: "tool_result",
tool_use_id: "tool_1",
content: "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
role: "assistant",
content: [
{
type: "text",
text: "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
role: "user",
content: [
{
type: "text",
text: "Yes, please tell me about the Perseverance rover specifically.",
cache_control: { type: "ephemeral" }
}
]
}
]
)
puts message.usage
```
Este exemplo abrangente demonstra como usar todos os 4 breakpoints de cache disponíveis para otimizar diferentes partes do seu prompt:
1. **Cache de ferramentas** (breakpoint de cache 1): O parâmetro `cache_control` na última definição de ferramenta armazena em cache todas as definições de ferramentas.
2. **Cache de instruções reutilizáveis** (breakpoint de cache 2): As instruções estáticas no prompt do sistema são armazenadas em cache separadamente. Essas instruções raramente mudam entre solicitações.
3. **Cache de contexto RAG** (breakpoint de cache 3): Os documentos da base de conhecimento são armazenados em cache de forma independente, permitindo que você atualize os documentos de "retrieval-augmented generation" (geração aumentada por recuperação), ou RAG, sem invalidar o cache de ferramentas ou de instruções.
4. **Cache do histórico da conversa** (breakpoint de cache 4): A mensagem final do usuário é marcada com `cache_control` para permitir o cache incremental da conversa à medida que ela avança.
Essa abordagem oferece máxima flexibilidade:
* Se você acrescentar um novo turno à conversa sem alterar o conteúdo anterior, todos os quatro segmentos de cache são reutilizados
* Se você atualizar os documentos RAG, mas mantiver as mesmas ferramentas e instruções, os dois primeiros segmentos de cache são reutilizados
* Se você alterar a conversa, mas mantiver as mesmas ferramentas, instruções e documentos, os três primeiros segmentos são reutilizados
* Alterações em qualquer breakpoint invalidam aquele segmento e tudo o que vem depois dele, enquanto os segmentos anteriores em cache permanecem válidos
Para a primeira solicitação:
* `input_tokens`: Mínimo (tokens após o último breakpoint de cache, próximo de 0 neste exemplo)
* `cache_creation_input_tokens`: Tokens em todos os segmentos em cache (ferramentas + instruções + documentos RAG + histórico da conversa)
* `cache_read_input_tokens`: 0 (nenhum acerto de cache)
Para solicitações subsequentes com apenas uma nova mensagem do usuário (e o quarto breakpoint movido para essa nova mensagem final, como no exemplo):
* `input_tokens`: Mínimo (tokens após o último breakpoint de cache, próximo de 0 neste exemplo)
* `cache_creation_input_tokens`: Tokens na nova mensagem do usuário e no turno anterior do assistente (o novo segmento da conversa sendo armazenado em cache)
* `cache_read_input_tokens`: Todos os tokens previamente armazenados em cache (ferramentas + instruções + documentos RAG + conversa anterior)
Esse padrão é especialmente poderoso para:
* Aplicações RAG com grandes contextos de documentos
* Sistemas de agentes que usam múltiplas ferramentas
* Conversas de longa duração que precisam manter o contexto
* Aplicações que precisam otimizar diferentes partes do prompt de forma independente
## Retenção de dados
O cache de prompt (tanto automático quanto explícito) é elegível para "Zero Data Retention" (retenção zero de dados), ou ZDR. A Anthropic não armazena o texto bruto dos seus prompts nem das respostas do Claude.
As representações de cache de "key-value" (chave-valor), ou KV, e os hashes criptográficos do conteúdo em cache são mantidos apenas em memória e não são armazenados em repouso. As entradas em cache têm um tempo de vida mínimo de 5 minutos (padrão) ou 1 hora (estendido), após o qual são excluídas prontamente, embora não imediatamente. As entradas de cache são isoladas entre organizações e, na Claude API, no Claude Platform on AWS e no Microsoft Foundry, entre workspaces dentro de uma organização.
Para a elegibilidade para ZDR em todos os recursos, consulte [API e retenção de dados](https://platform.claude.com/docs/pt-BR/manage-claude/api-and-data-retention).
***
## Perguntas frequentes
**Na maioria dos casos, um único breakpoint de cache no final do seu conteúdo estático é suficiente.** As escritas de cache acontecem apenas no bloco que você marca. Coloque-o no último bloco que permanece idêntico entre as solicitações, e cada solicitação subsequente lerá essa mesma entrada. Se um bloco posterior variar a cada solicitação (um timestamp, a mensagem recebida), mantenha o breakpoint antes dele, no último bloco estável.
Você só precisa de múltiplos breakpoints se:
* Uma conversa crescente empurrar seu breakpoint 20 ou mais blocos além da última escrita de cache, colocando a entrada anterior fora da "lookback window" (janela de retrospectiva)
* Você quiser armazenar em cache, de forma independente, seções que são atualizadas em frequências diferentes
* Você precisar de controle explícito sobre o que é armazenado em cache para otimização de custos
Exemplo: se você tiver instruções do sistema (que raramente mudam) e contexto RAG (que muda diariamente), pode usar dois breakpoints para armazená-los em cache separadamente.
Não, os breakpoints de cache em si são gratuitos. Você paga apenas por:
* Escrever conteúdo no cache (25% a mais que os tokens de entrada base para TTL de 5 minutos)
* Ler do cache (uma fração do preço base dos tokens de entrada, consulte [Preços](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#pricing))
* Tokens de entrada regulares para conteúdo não armazenado em cache
O número de breakpoints não afeta o preço; apenas a quantidade de conteúdo armazenado em cache e lido importa.
A resposta de uso inclui três campos separados de tokens de entrada que, juntos, representam sua entrada total:
```text wrap
total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens
```
* `cache_read_input_tokens`: Tokens recuperados do cache (tudo antes dos breakpoints de cache que foi armazenado em cache)
* `cache_creation_input_tokens`: Novos tokens sendo escritos no cache (nos breakpoints de cache)
* `input_tokens`: Tokens **após o último breakpoint de cache** que não estão em cache
**Importante:** `input_tokens` NÃO representa todos os tokens de entrada, apenas a parte após seu último breakpoint de cache. Se você tiver conteúdo em cache, `input_tokens` normalmente será muito menor que sua entrada total.
**Exemplo:** com um documento de 200k tokens em cache e uma pergunta do usuário de 50 tokens:
* `cache_read_input_tokens`: 200.000
* `cache_creation_input_tokens`: 0
* `input_tokens`: 50
* **Total:** 200.050 tokens
Esse detalhamento é fundamental para entender tanto seus custos quanto o uso do seu "rate limit" (limite de taxa). Consulte [Acompanhando o desempenho do cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#tracking-cache-performance) para mais detalhes.
O tempo de vida mínimo padrão do cache (TTL) é de 5 minutos. Esse tempo de vida é renovado cada vez que o conteúdo em cache é usado.
Se você achar que 5 minutos é muito pouco, a Anthropic também oferece um [TTL de cache de 1 hora](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#1-hour-cache-duration).
O tempo de vida é medido a partir do início da solicitação que escreve ou lê a entrada de cache, e não a partir do fim de sua resposta. O tempo gasto gerando uma resposta conta para o tempo de vida, então a janela para que uma solicitação seguinte reutilize o cache é o tempo de vida menos o tempo de geração.
Se suas solicitações produzem respostas longas e a próxima solicitação pode não começar antes de o tempo de vida expirar, use o [TTL de cache de 1 hora](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#1-hour-cache-duration).
Você pode definir até 4 breakpoints de cache (usando parâmetros `cache_control`) no seu prompt.
O cache de prompt é suportado em todos os [modelos Claude ativos](https://platform.claude.com/docs/pt-BR/models/overview).
Alterar os parâmetros de thinking (trocar de modo ou alterar o orçamento no modo estendido) invalida os prefixos de mensagens em cache e também pode invalidar prompts do sistema e ferramentas em cache, porque a configuração de thinking é renderizada no prompt. O valor de [`output_config.effort`](https://platform.claude.com/docs/pt-BR/build-with-claude/effort) se comporta da mesma forma.
Para mais detalhes sobre invalidação de cache, consulte [O que invalida o cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#what-invalidates-the-cache).
Para mais informações sobre thinking, incluindo sua interação com o uso de ferramentas e o cache de prompt, consulte [Thinking e cache de prompt](https://platform.claude.com/docs/pt-BR/build-with-claude/thinking#thinking-and-prompt-caching).
A maneira mais fácil é adicionar `"cache_control": {"type": "ephemeral"}` no nível superior do corpo da sua solicitação ([cache automático](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#automatic-caching)). Alternativamente, inclua pelo menos um breakpoint `cache_control` em blocos de conteúdo individuais ([breakpoints de cache explícitos](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#explicit-cache-breakpoints)).
Sim, o cache de prompt pode ser usado junto com outros recursos da API, como uso de ferramentas e recursos de visão. No entanto, alterar se há imagens em um prompt ou modificar as configurações de uso de ferramentas quebrará o cache.
Para mais detalhes sobre invalidação de cache, consulte [O que invalida o cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#what-invalidates-the-cache).
O cache de prompt introduz uma nova estrutura de preços em que as escritas de cache de 5 minutos custam 25% a mais que os tokens de entrada base, as escritas de cache de 1 hora custam 2x os tokens de entrada base e os acertos de cache custam uma fração do preço base dos tokens de entrada (consulte [Preços](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#pricing) para o multiplicador por modelo).
Atualmente, não há como limpar o cache manualmente. Os prefixos em cache expiram automaticamente após um mínimo de 5 minutos de inatividade.
Você pode monitorar o desempenho do cache usando os campos `cache_creation_input_tokens` e `cache_read_input_tokens` na resposta da API.
Consulte [O que invalida o cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#what-invalidates-the-cache) para mais detalhes sobre invalidação de cache, incluindo uma lista de alterações que exigem a criação de uma nova entrada de cache.
O cache de prompt foi projetado com fortes medidas de privacidade e separação de dados:
1. As chaves de cache são geradas usando um hash criptográfico dos prompts até o ponto de controle de cache. Isso significa que apenas solicitações com prompts idênticos podem acessar um cache específico.
2. Na Claude API, no Claude Platform on AWS e no Microsoft Foundry, os caches são isolados por workspace dentro de uma organização. No Bedrock e no Google Cloud, os caches são isolados por organização. Em todos os casos, os caches nunca são compartilhados entre organizações, mesmo para prompts idênticos. Consulte [Armazenamento e compartilhamento de cache](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#cache-storage-and-sharing) para mais detalhes.
3. O mecanismo de cache foi projetado para manter a integridade e a privacidade de cada conversa ou contexto único.
4. É seguro usar `cache_control` em qualquer lugar dos seus prompts. Para que o cache produza leituras, coloque o breakpoint no final de um prefixo estável: colocá-lo em um bloco que muda a cada solicitação (como um timestamp ou a entrada arbitrária do usuário) escreve uma nova entrada a cada vez e nunca gera acertos.
Essas medidas garantem que o cache de prompt mantenha a privacidade e a segurança dos dados, ao mesmo tempo em que oferece benefícios de desempenho.
Sim, é possível usar o cache de prompt com suas solicitações da [Batches API](https://platform.claude.com/docs/pt-BR/build-with-claude/batch-processing). No entanto, como as solicitações em lote assíncronas podem ser processadas simultaneamente e em qualquer ordem, os acertos de cache são fornecidos com base no melhor esforço.
O [cache de 1 hora](https://platform.claude.com/docs/pt-BR/build-with-claude/prompt-caching#1-hour-cache-duration) pode ajudar a melhorar seus acertos de cache. A maneira mais econômica de usá-lo é a seguinte:
* Reúna um conjunto de solicitações de mensagens que tenham um prefixo compartilhado.
* Envie uma solicitação em lote com uma única solicitação que tenha esse prefixo compartilhado e um bloco de cache de 1 hora. Isso escreve o prefixo no cache de 1 hora.
* Assim que isso for concluído, envie o restante das solicitações. Você precisará monitorar o job para saber quando ele for concluído.
Isso normalmente é melhor do que usar o cache de 5 minutos, porque é comum que solicitações em lote levem entre 5 minutos e 1 hora para serem concluídas.
Esse erro normalmente aparece quando você atualizou seu SDK ou está usando exemplos de código desatualizados. O cache de prompt não exige mais o prefixo beta. Em vez de:
```python Python
client.beta.prompt_caching.messages.create(**params)
```
Use:
```python Python
client.messages.create(**params)
```
Esse erro normalmente aparece quando você atualizou seu SDK ou está usando exemplos de código desatualizados. O cache de prompt não exige mais o prefixo beta. Em vez de:
```typescript TypeScript
client.beta.promptCaching.messages.create(/* ... */);
```
Use:
```typescript
client.messages.create(/* ... */);
```